AI行业发展史:从早期探索到大模型与生成式AI
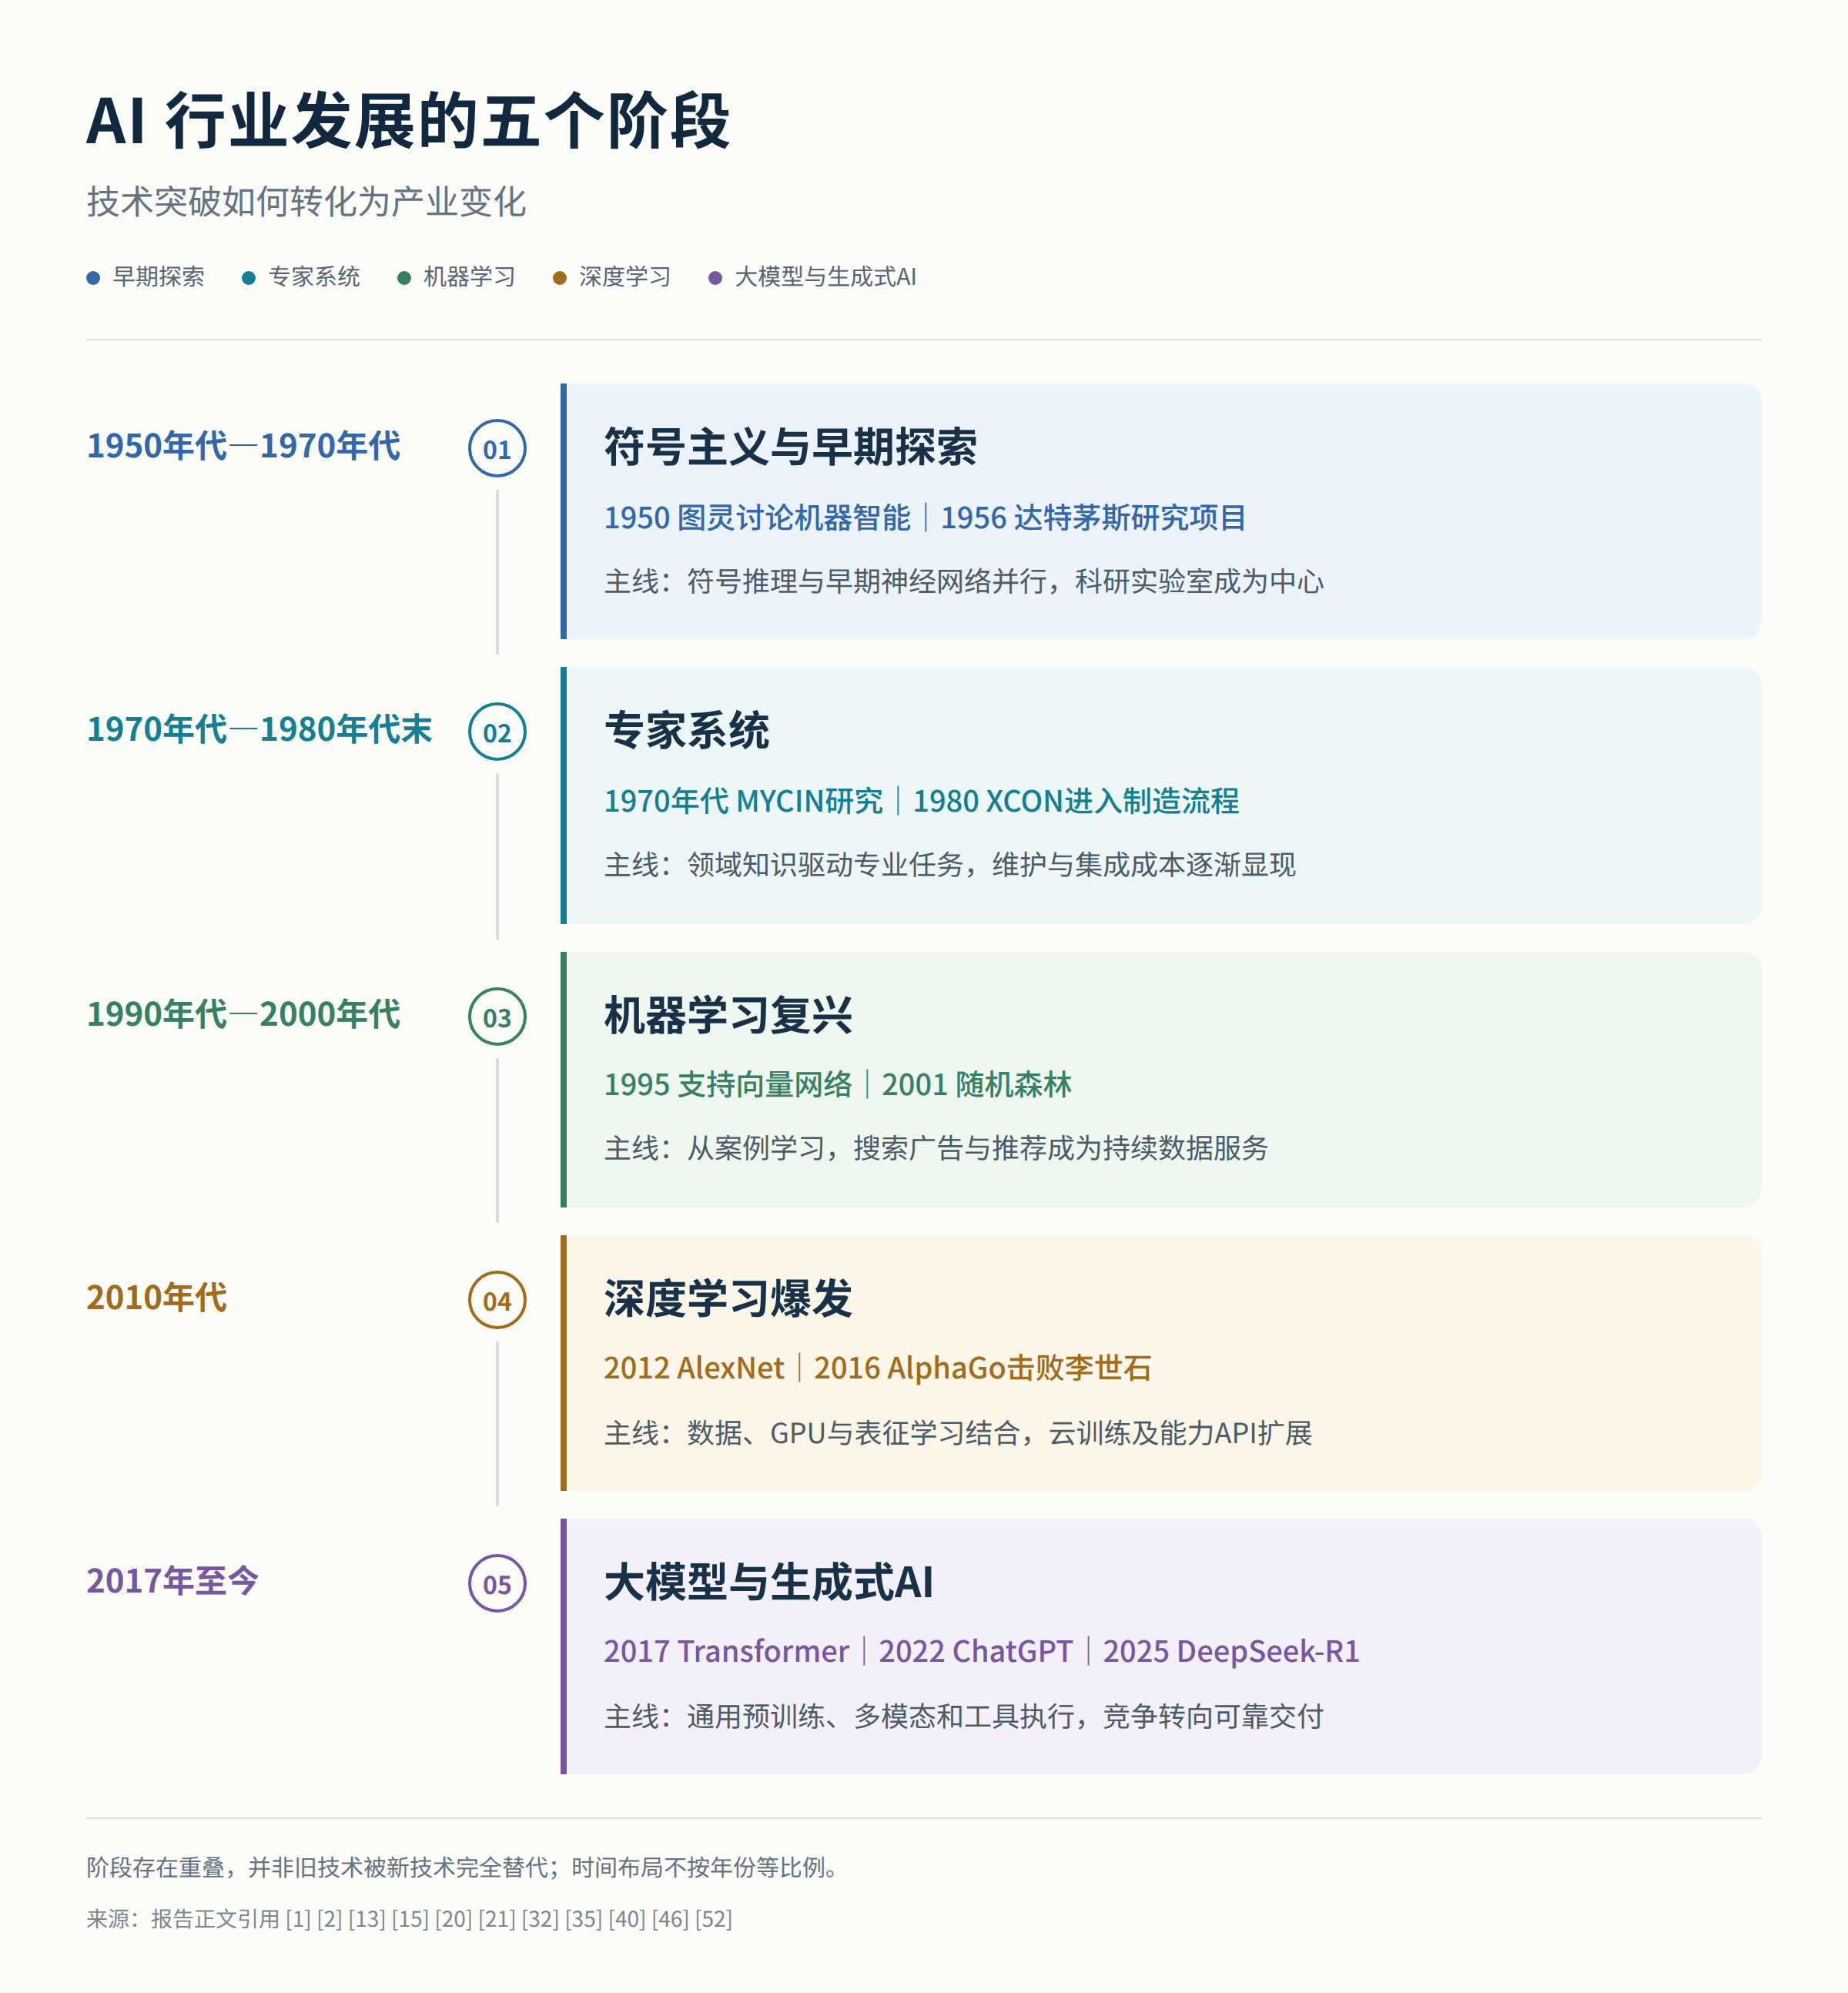
图 1|五阶段发展时间轴。阶段彼此重叠,图中年代布局不按年份等比例;里程碑依据正文引用整理。
一、符号主义与早期探索:1950年代至1970年代
机器智能成为一个研究领域
1950 年 10 月,艾伦·图灵在《Computing Machinery and Intelligence》中提出“模仿游戏”,把机器智能的讨论转向可以观察的交互行为。他也讨论了“学习机器”:与其直接编写完整的成人智能,不如构造能够通过教育和经验发展的儿童机器。因此,早期 AI 既有规则推理,也有学习的设想;下述五个阶段彼此重叠,并不意味着新范式出现后旧范式就彻底消失。[1]
1955 年 8 月 31 日,约翰·麦卡锡、马文·明斯基、纳撒尼尔·罗切斯特和克劳德·香农提出达特茅斯夏季研究计划,实际研究项目于 1956 年举行。提案计划在两个月内组织约十人研究,议题既包括语言和问题求解,也包括神经网络。这两个日期应分开理解:1955 年是提案,1956 年是研究项目;计划人数和时长也不是所有参与者全程出席的记录。[2]
这一时期的重要变化,不是机器已经获得通用智能,而是机器智能开始拥有专门程序、研究组织和资助体系。达特茅斯项目得到洛克菲勒基金会及企业支持。美国 ARPA 于 1962 年设立信息处理技术办公室后,公共资助扩大了 MIT、Carnegie Tech 和 Stanford 等核心研究中心的规模。昂贵的大型计算机与长期研究经费,使早期 AI 集中在少数大学和机构实验室。[3]
符号推理与连接主义并行
符号路线把对象和关系写成明确表示,再通过规则与搜索求解。Newell、Simon 和 J. C. Shaw 于 1955—1956 年合作开发 Logic Theorist,寻找《Principia Mathematica》中的逻辑定理证明。其技术报告说明了符号替换、推理规则和子问题分解,也强调启发式方法并不保证找到证明。所谓启发式,是用估计或经验优先探索较有希望的路径,以减少盲目穷举。[3] [4]
1968 年的 A* 算法进一步把已经走过的路径代价与剩余代价估计结合起来。在估计不高估剩余最小代价等条件下,它能够找到最优路径。这说明早期研究不仅提出宏大的智能目标,也产出了适用范围和保证条件清楚的算法。[5]
与符号路线同时发展的感知机,则尝试从样本调整连接。Rosenblatt 的 1958 年论文明确采用连接主义观点,用连接与关联保存信息,以概率方法分析模型,而不是依靠符号逻辑推演。它代表有限模式分类的探索,不应被描述为已经理解任意图像。[6]
1969 年的《Perceptrons》分析了受限感知机的表示能力,涉及异或、奇偶性和连通性等问题。这些限制不能扩展为“所有多层神经网络都不可能成功”。理解这场争论,需要区分当时分析的模型与后来发展的网络结构,而不是把一本书解释成神经网络路线终结的唯一原因。[7]
演示能力、资助压力与领域知识的兴起
SRI 于 1966—1972 年研究的 Shakey 机器人把感知、规划和寻路整合起来,并能移动简单对象。它展示了系统集成的潜力,但工作环境和任务仍然受限。媒体对“电子人”的描述,与实际演示范围之间已有明显落差。[8]
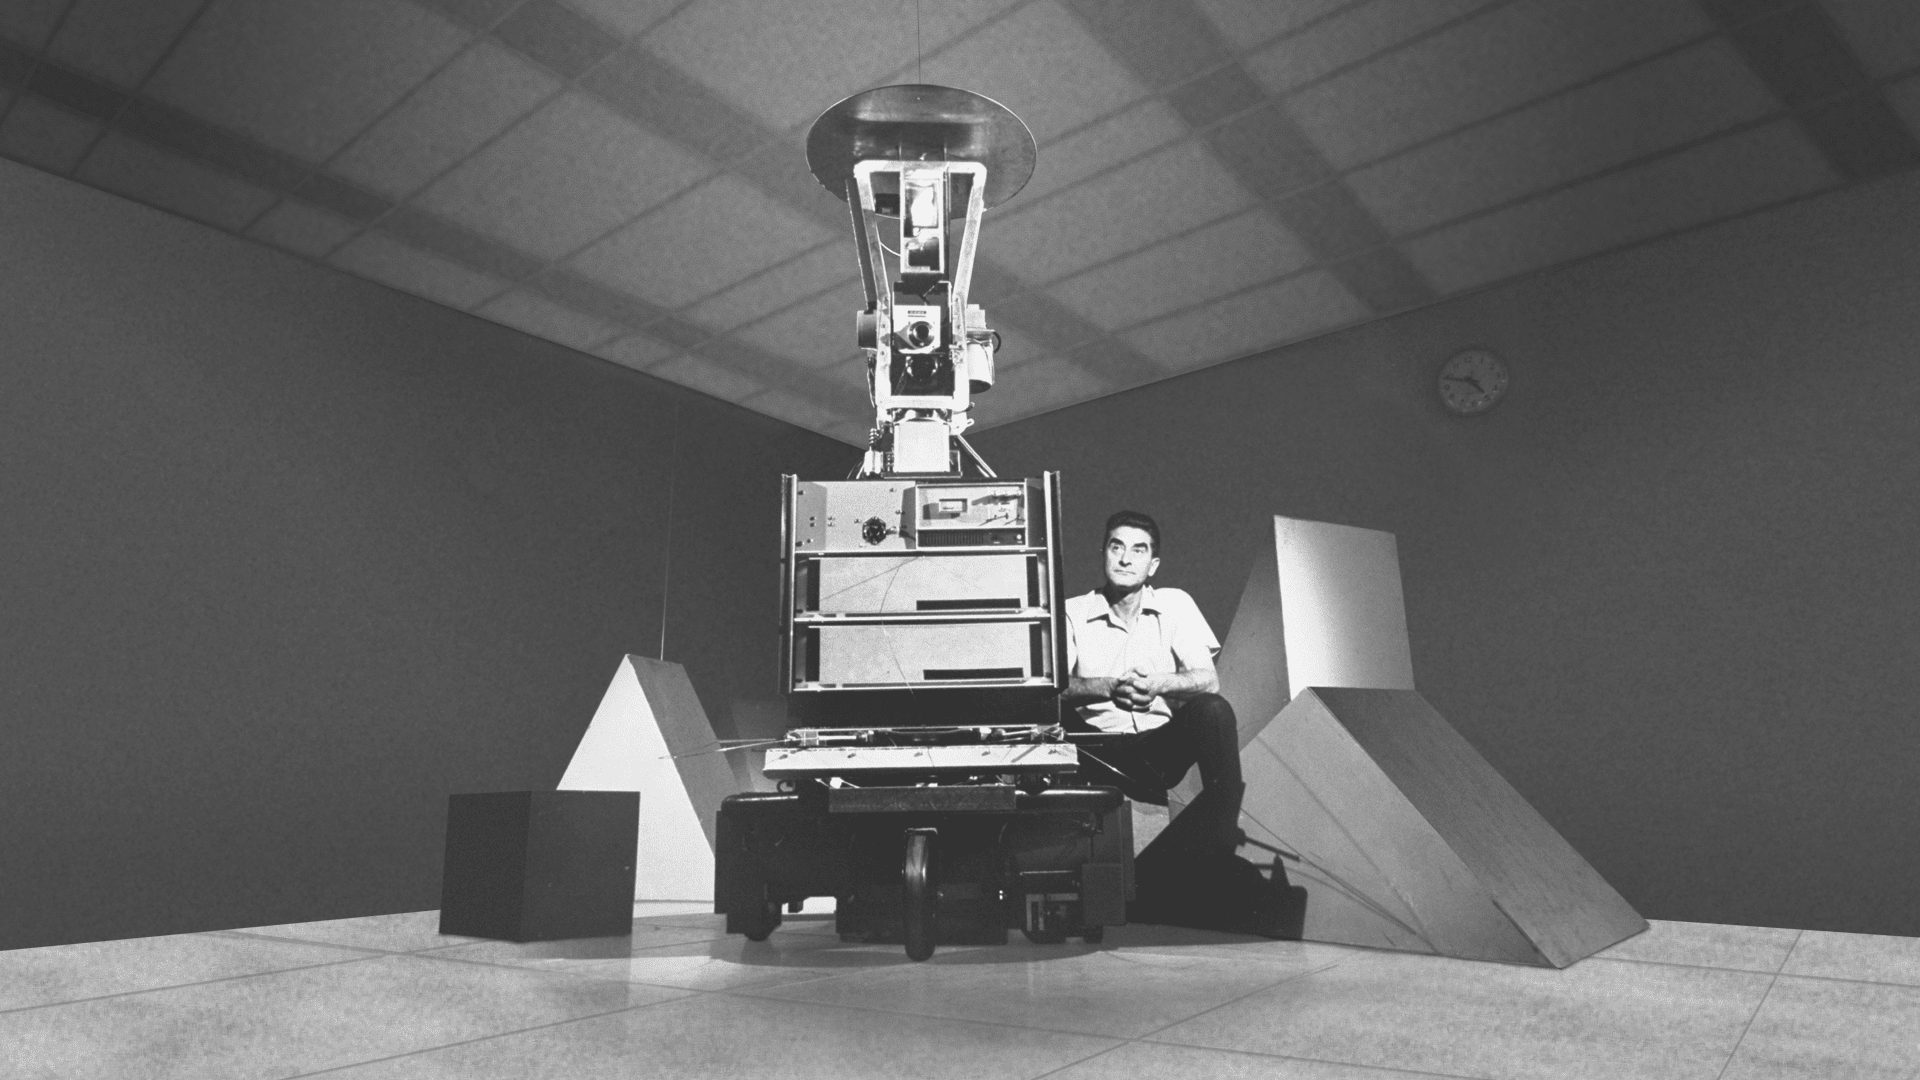
图 2|Shakey 与受控实验环境。SRI 于 1966—1972 年开展该项目,机器人把感知、推理与移动结合起来,但任务环境仍有限。图片出处:SRI 公开介绍页;照片具体拍摄日期未注明。[8] [64]
通用求解面临的核心困难是组合爆炸:问题规模稍有增加,候选状态和搜索路径就可能急剧增多。英国 Lighthill 报告正文署于 1972 年、于 1973 年出版,对一般机器智能研究提出这一批评,同时承认一些自动化和神经科学研究的进展。它并不是对所有 AI 工作的统一否定。[9]
资助环境也开始更重视可交付的任务结果。1969 年的 Mansfield Amendment 要求国防基础研究具有直接且明显的军事用途;此后 DARPA 强化了实效和报告要求,部分机器人及宏大通用智能项目受到压力。不过,美国国家研究委员会的历史研究指出,流向 CMU、MIT 和 Stanford 的 AI 资金并没有停止,也没有大幅减少。[3]
因此,通常所说的“第一次 AI 寒冬”更适合描述部分路线受挫和资助规则变化,而不是全球研究同步停摆。历史学者 Thomas Haigh 还指出,SIGART 会员人数在 1973—1978 年间继续增长,提示这一分期存在争议。[10]
面对一般求解的扩展困难,领域知识变得更有吸引力。1965 年启动的 DENDRAL 根据化学知识和分析数据推断分子结构,显示范围明确的任务可以比宏大的通用目标更容易形成可检验成果。这一转向,为专家系统阶段提供了直接动因。[3]
二、专家系统:1970年代至1980年代末
把专业知识变成可执行系统
专家系统把特定领域的经验写入知识库,再由推理机使用这些知识。典型规则可以表达为“如果出现某些条件,则提出某种判断或行动”。知识库与推理程序分离,使系统能够通过修改知识适应任务变化,而不必每次重写整个程序。系统也可以处理不确定性:MYCIN 使用确定性因子,XCON 则是前向链推理的经典案例。[11] [12]
这一架构带来了“知识工程”工作。领域专家掌握经验,但经验往往没有完整写成规则;系统建设者需要提取、整理和测试这些知识。1988 年的综述已把知识获取视为长期瓶颈,并指出缺少常识或原理知识的系统可能在能力边缘的新案例上突然失败。[12]
DENDRAL 是这一转向的重要范例。它依据质谱等分析信息和化学约束,生成并评价分子结构候选。开发团队以外的化学家曾将其用于研究,一些衍生程序和算法也获得商业使用。不过,1993 年的作者回顾指出,完整系统只在少数实验室使用,对有机化学实际工作的总体影响有限。它证明了领域知识的价值,却不等于专家系统已经普遍替代科学家的工作。[11]
MYCIN与XCON:研究表现和流程落地的差别
MYCIN 最初研究菌血症,后来扩展到脑膜炎,提供感染判断和抗微生物治疗建议。1979 年的一项盲评由八位独立专家评价十个脑膜炎病例,MYCIN 的治疗建议获得 65% 的可接受评价。这是小样本病例评审中的建议评分,不是诊断准确率、治愈率或临床试验有效率。[13]
更重要的是,MYCIN 从未在患者照护中例行使用。开发者记录的障碍包括数据重复输入、工作流整合、共享计算机响应和可靠性,以及知识库扩展所需资金与人员。1978 年末以后,它主要成为静态演示和学生项目系统;抗菌药物继续变化,知识库随后迅速过时。研究中表现良好,并不能自动转化为日常工作中的可用系统。[14]
DEC 的 R1/XCON 则提供了真正嵌入企业流程的例子。开发始于 1978 年 12 月,1980 年的论文报告它自当年 1 月以来已处理超过 500 份订单,并接入 DEC 制造组织。系统最初针对 VAX-11/780 补齐订单组件,并生成技术员使用的装配图纸。这里的价值来自把配置判断连接到订单和制造,而不只是展示规则推理。[15]
到 1989 年,DEC 的配置系统家族已经用于销售、制造、现场服务和工程流程,支持全球超过 50 个生产安装站点。公司团队估计,整个系统家族每年净回报超过 4000 万美元。这个数字不是 XCON 单体的独立审计结果,却说明持续运营的知识系统可以形成企业可衡量的价值。[16]
同一篇论文报告,配置系统家族的知识库每年约 40% 的规则会发生增删或修改。产品变化不断带来新的配置条件,维护因此成为正常运营,而不是上线前的一次性工程。这一比例也不能解读成 XCON 单体规则每年的“失效率”。[16]
商业热潮为何收缩
专家系统的商业化扩展到开发工具、系统建设服务和企业内部知识工程团队。专用 Lisp 机器为大型符号程序提供了开发与运行环境,但专家系统并不必然依赖它们:1980 年的 R1 使用 OPS4,运行在 PDP-10 上;DEC 后期配置系统则采用 VAX OPS5。[15] [16]
专用硬件的优势随后受到通用平台挑战。Symbolics 联合创始人 Dan Weinreb 的回忆指出,通用工作站上的 Lisp 实现、Unix 应用的可移植性和通用处理器的价格性能,削弱了专用机器的竞争力。他也把专家系统炒作反弹、资助变化和内部管理问题列为衰退因素。这是参与者对衰退机制的解释,不宜简化成单一技术路线遭到淘汰。[17]
1980 年代后期,专家系统市场、投资和部分项目出现收缩,通常被归入“第二次 AI 寒冬”。过高预期遇到了知识获取、维护和集成成本,专用硬件又失去部分优势。但 AI 研究与教学并未全部停止,各地区的变化也不完全一致。[18]
这一阶段留下的关键问题是:能否减少逐条获取知识的成本,让系统从案例和经验中学习?当时的专家系统研究已经讨论从案例归纳规则。因此,机器学习不是突然从外部取代知识工程,而是也在回应知识工程自身暴露的问题。[12]
三、机器学习复兴:1990年代至2000年代
从编写规则转向学习模型
这一阶段的重心,是把更多任务转成从样本学习的预测问题,再用未参与训练的数据检验泛化表现。规则并没有消失:1993 年的 C4.5 可以从带标签案例学习决策树,也可以输出 IF-THEN 规则,并通过剪枝控制模型复杂度。变化在于规则可以由数据归纳,而不再完全依赖专家逐条提供。[19]
1995 年的支持向量网络把最大间隔、软间隔与核计算结合起来。软间隔允许训练样本不能完全分开,核方法则提供处理非线性分类的途径。它把分类能力、泛化控制和计算可行性结合起来,但特征映射仍需预先选择。[20]
2001 年的随机森林组合多棵随机化决策树,以投票进行分类,也可用于回归。单树能力和树间相关性共同影响结果,袋外样本可以帮助估计误差与变量重要性。集成更多树不应被解释成任何任务上都不会过拟合。[21]
这些方法让特征设计、数据质量和评估方式成为日常工程工作。对于序列任务,隐马尔可夫模型等统计方法已在此前形成,并在这一时期扩散到实际语音服务。1990 年代后期的电话呼叫处理、航空查询,以及 2000 年进入客服的 AT&T“如何帮助您”系统,都依靠统计建模、搜索解码与对话流程。限定任务的成功,仍然不同于在噪声中进行开放领域自由交谈。[22]
决策学习的进展与Deep Blue的不同路线
强化学习研究让系统从行动后果中学习。Watkins 与 Dayan 的 1992 年 Q-learning 论文在特定马尔可夫环境以及采样、学习率和离散价值表示等条件下,证明动作价值可以收敛到最优值。这使“无需预先知道完整环境转移规律也能学习”具有明确的理论基础,但不构成任意现实任务都能成功的保证。[23]
1997 年 Deep Blue 以 3.5 比 2.5 赢下与卡斯帕罗夫的六局比赛,是这一时期影响广泛的事件。但它不能被当作纯粹自我学习的代表。开发团队的技术论文说明,绝大多数评价特征和权重由人工建立或调整,部分自动分析和训练工具辅助调参;大规模搜索、专用计算与棋类知识共同决定了系统能力。[24]
Deep Blue 也说明,AI 进展并不只来自当时最受关注的学习范式。一个明确任务可以通过搜索工程和人工知识取得突破,而不必先解决一般智能。
互联网把预测能力接入持续收入
互联网提供了大规模数据,也形成了持续使用模型的商业场景。1998 年的 Google 论文描述了至少 2400 万网页的全文和超链接数据库。PageRank 从链接图计算网页重要性,再与抓取、索引和查询系统结合。早期 PageRank 不是用点击标签训练的监督学习排序器,搜索成功也不能全部归因于机器学习。[25]
Google 于 2000 年 10 月 23 日发布 AdWords,将关键词投放、预算控制和效果报告提供给广告主。初期发布描述的是按展示收费,不能与后来按点击收费的模式混用。随后,点击率预测成为搜索广告的重要学习组件:微软 2007 年的论文用逻辑回归及广告、关键词和广告主等特征估计新广告的点击概率,使缺乏历史数据的广告也能参与排序。预测模型与广告资格规则、拍卖及计价共同组成商业系统。[26] [27]
电子商务推荐形成了另一条路径。Amazon 于 2003 年介绍商品间协同过滤:从共同购买行为离线计算相似商品表,再在线结合用户购买和评分生成推荐,应用于首页、购物车和邮件营销。商业价值不仅来自推荐算法,也来自大规模数据处理和在线低延迟服务的结合。[28]
搜索广告和推荐让模型输出与用户行为、收入及后续数据连接起来。与一次性交付的专家系统相比,AI 开始更多作为持续运行的数据服务存在;业务规则与模型仍需协同,而不是由模型单独决定全部流程。[27] [28]
更深的表示为什么重新受到关注
数据增多并不自动解决特征表示和深层网络训练问题。Hinton、Osindero 与 Teh 于 2006 年提出深度信念网络训练方法,先逐层学习,再进行微调,在手写数字任务上展示多层表示的潜力。论文也承认自然图像和感知不变性等限制。这是向下一阶段的过渡,而不是当时已经实现通用智能。[29]
四、深度学习爆发:2010年代
表征学习与共同评测推动突破
深度学习不是 2012 年才被发明。2015 年的《Nature》综述回顾了卷积网络在 1990 年代文档识别和语音识别中的应用。2010 年代更重要的变化,是多层网络训练方法、大规模数据和 GPU 计算在共同评测任务上形成了显著突破。[30]
表征学习让模型从数据中学习任务所需的内部表示,减少完全依赖人工特征的做法。卷积神经网络通过局部连接与权重共享利用图像等数据的局部结构;循环神经网络用随序列更新的状态处理文本和语音,LSTM 改善长程信息保留,却不彻底消除长依赖学习困难。不同结构仍然针对不同数据特点,而不是由一种网络包办全部任务。[30]
ImageNet 于 2009 年发表,用 WordNet 语义层级组织图像,并借助人工标注建立数据集。该论文所述版本有 320 万张图像和 5247 个同义词集合。2010 年开始的 ILSVRC 竞赛使用其子集;AlexNet 论文所述训练集约有 120 万张图像、1000 个类别,不能与完整数据库的不同版本混用。[31] [32]
2012 年的 AlexNet 采用五个卷积层和三个全连接层,结合 ReLU、数据增强与 dropout,在两块各有 3GB 显存的 GTX 580 GPU 上训练约五至六天。其 ILSVRC 参赛模型变体的 top-5 测试错误率为 15.3%,第二名为 26.2%。top-5 错误表示正确类别没有进入概率最高的五个预测,不能把这一数字直接当成单一预测准确率。[32]
这个结果的重要性,在于深度 CNN 在共同数据和评价条件下显示了显著优势。它并不意味着视觉理解已经完成,也不应被写成 2012 年从零创造深度学习。
生成和复杂决策扩大了能力范围
2014 年的生成对抗网络,即 GAN,提出同时训练生成器和判别器:生成器产生样本,判别器判断样本是否来自真实数据。原论文在手写数字、脸部图像和 CIFAR-10 等任务中展示生成潜力,也指出两网络更新失衡可能导致样本缺乏多样性。GAN 推进了深度生成研究,但不是生成式 AI 的起点。[33]
AlphaGo 则把深度学习与已有决策技术组合起来。2016 年 1 月论文中的系统同时使用策略网络、价值网络、人类棋谱监督学习、自我对弈强化学习和蒙特卡洛树搜索。它于 2015 年 10 月以 5 比 0 击败樊麾,随后于 2016 年 3 月以 4 比 1 击败李世石。论文中的前一场比赛与后来广为传播的李世石比赛是两个事件。[34] [35]
AlphaGo 的成就发生在规则明确的围棋领域。它不是语言模型,也不能作为通用智能已经实现的证据。它更清楚地展示了学习与搜索的互补:网络帮助评价和选择,搜索继续参与决策。[34]
云服务使训练与部署成为产业基础设施
云 GPU 并非 AlexNet 之后才出现。AWS 于 2010 年发布按使用量付费的 Cluster GPU Instance,将通用 GPU 计算作为云资源提供。深度学习需求增长后,计算资源逐步成为可以租用的平台能力,而不必全部自建。[36]
2016 年 Google 发布 Cloud Machine Learning alpha,支持基于 TensorFlow 的自定义分布式学习,并说明深度学习为 Cloud Vision、Cloud Speech 和 Cloud Translate API 提供能力。产业因此出现两条并行路径:开发者可以调用已有视觉或语音服务,也可以使用云资源训练自己的模型。[37]
深度网络也进入控制研究。NVIDIA 于 2016 年发表的 DAVE-2 工作,从摄像头图像联合学习特征和转向输出,展示端到端道路跟随。但研究选择车道保持数据,路测自主转向时间的计算排除了换道和转入其他道路。它是特定驾驶功能的研究示范,不是完全自动驾驶已经解决。[38]
模型上线又产生了独立问题。AWS 于 2018 年推出 Elastic Inference,将 GPU 推理加速作为可附加服务,说明延迟、资源配置和推理成本已不再只是训练阶段的附属事项。[39]
2017 年的 Transformer 论文用机器翻译验证以注意力为核心的架构,回应循环计算的并行化瓶颈和长距离依赖问题。它提高了训练并行性,为更大规模预训练提供结构基础,但这并不意味着生成文本时不再逐步输出。[40]
五、大模型与生成式AI:2017年至已核实的近期进展
预训练模型成为可复用的任务底座
Transformer 之后,预训练与任务适配逐步形成通用模型路线。2018 年 6 月的第一代 GPT 工作,把单向 Transformer 语言模型预训练与具体任务监督微调结合;同年 10 月首次发表的 BERT,通过双向上下文学习表示,再微调用于语言理解。二者体现了预训练的不同使用方式,BERT 也不应被直接等同于生成式聊天模型。[41] [42]
2020 年 GPT-3 论文报告 1750 亿参数模型,并展示通过输入任务说明与少量示例完成任务的方式。这些少样本实验没有进行梯度更新,使任务适配部分转移到输入内容,而不必为每个任务重新训练模型。论文同时指出任务失败和网页训练数据带来的评测问题,因此少样本能力并不是全面可靠性的保证。[43]
同年 6 月,OpenAI 推出基于 GPT-3 家族的通用文本 API,最初为 private beta。商业模式由交付单个任务系统,扩展到提供可购买的模型接口,让开发者围绕同一底座构建不同应用。[44]
仅有预训练仍不能保证模型按照用户意图回答。2022 年的 InstructGPT 先用人类示范进行监督微调,再通过人类对回答的排序开展基于人类反馈的强化学习,即 RLHF。这让“更符合指令和偏好”成为训练目标,但人类偏好提升不等于事实正确性,论文也明确承认模型仍会犯错。[45]
2022 年 11 月 30 日,ChatGPT 作为免费研究预览发布,把 GPT-3.5 系列模型、对话微调和 RLHF 封装为大众可直接使用的交互产品。自然语言由此成为调用模型能力的界面;与此同时,原始发布就警告模型会生成貌似合理却错误的回答。[46]
生成式应用从文本扩展到多模态
图像生成的发展并不是 ChatGPT 带来的附属现象。2021 年 12 月首次发表、后进入 CVPR 2022 的潜空间扩散工作,在压缩表示中进行去噪,并接入文本条件,以降低像素空间扩散的计算负担。2022 年 8 月 22 日 Stable Diffusion 公开发布权重和代码,同时提供 DreamStudio,形成托管服务与可定制模型组件并行的路线。其 OpenRAIL-M 许可允许商业使用,但附带使用条件,不能称为无限制的完全开源。[47] [48]
语言模型也扩展了输入输出范围。2023 年的 GPT-4 技术报告描述图像和文本输入、文本输出的模型,同时承认许多真实场景中仍不如人类。2024 年 5 月发布的 GPT-4o 进一步采用文本、视觉与音频端到端的同一网络。不过,发布当日公开的模态与随后分期推出的能力需要区分,演示并不意味着当天所有 API 能力都已可用。[49] [50]
多模态增加了处理材料和交互的方式,却没有自动解决事实核查和专业判断问题。考试成绩、图像理解展示与职业实践中的可靠性,仍是不同的评价对象。[49]
推理计算与开放权重改变部署选择
2024 年 9 月的 o1 发布,把强化学习与回答时的推理计算结合,展示增加训练和测试时计算可以改善部分推理基准。竞争维度由训练一个多大的模型,进一步扩展到一次任务愿意投入多少推理计算。单次回答、多个样本投票和大量样本重排的成绩并不相同,比较时需要看清计算预算。[51]
2025 年 1 月发布的 DeepSeek-R1 展示了另一条推理模型路线。技术报告区分直接从基础模型进行纯强化学习的 R1-Zero,以及先用长推理示例冷启动、随后结合强化学习与监督微调的 R1,不能把整个 R1 描述成完全没有监督训练。官方同时提供 MIT 许可的代码和权重,以及网站和 API 访问。[52] [53]
2025 年 4 月的 Qwen3 发布提供稠密和混合专家模型,支持思考与非思考模式以及推理预算控制,并提供工具调用路线。同年 8 月,OpenAI 发布 gpt-oss 开放权重推理模型,支持工具调用和不同推理强度,提供量化权重及本地或第三方部署选择。这里的重要产业变化,是能力不只通过单一托管 API 供应,部署位置、推理预算和运行资源也成为应用设计的一部分。[54] [55]
开放权重与完整开源 AI 系统仍须区分。OSI 开源 AI 定义 1.0 除参数外,还要求充分数据信息和完整训练、运行代码,以及不限目的的使用、研究、修改与分享权利。因此,权重可下载,或者部分代码采用 MIT、Apache 许可,并不能单独证明整个训练系统符合这一完整定义。[56]
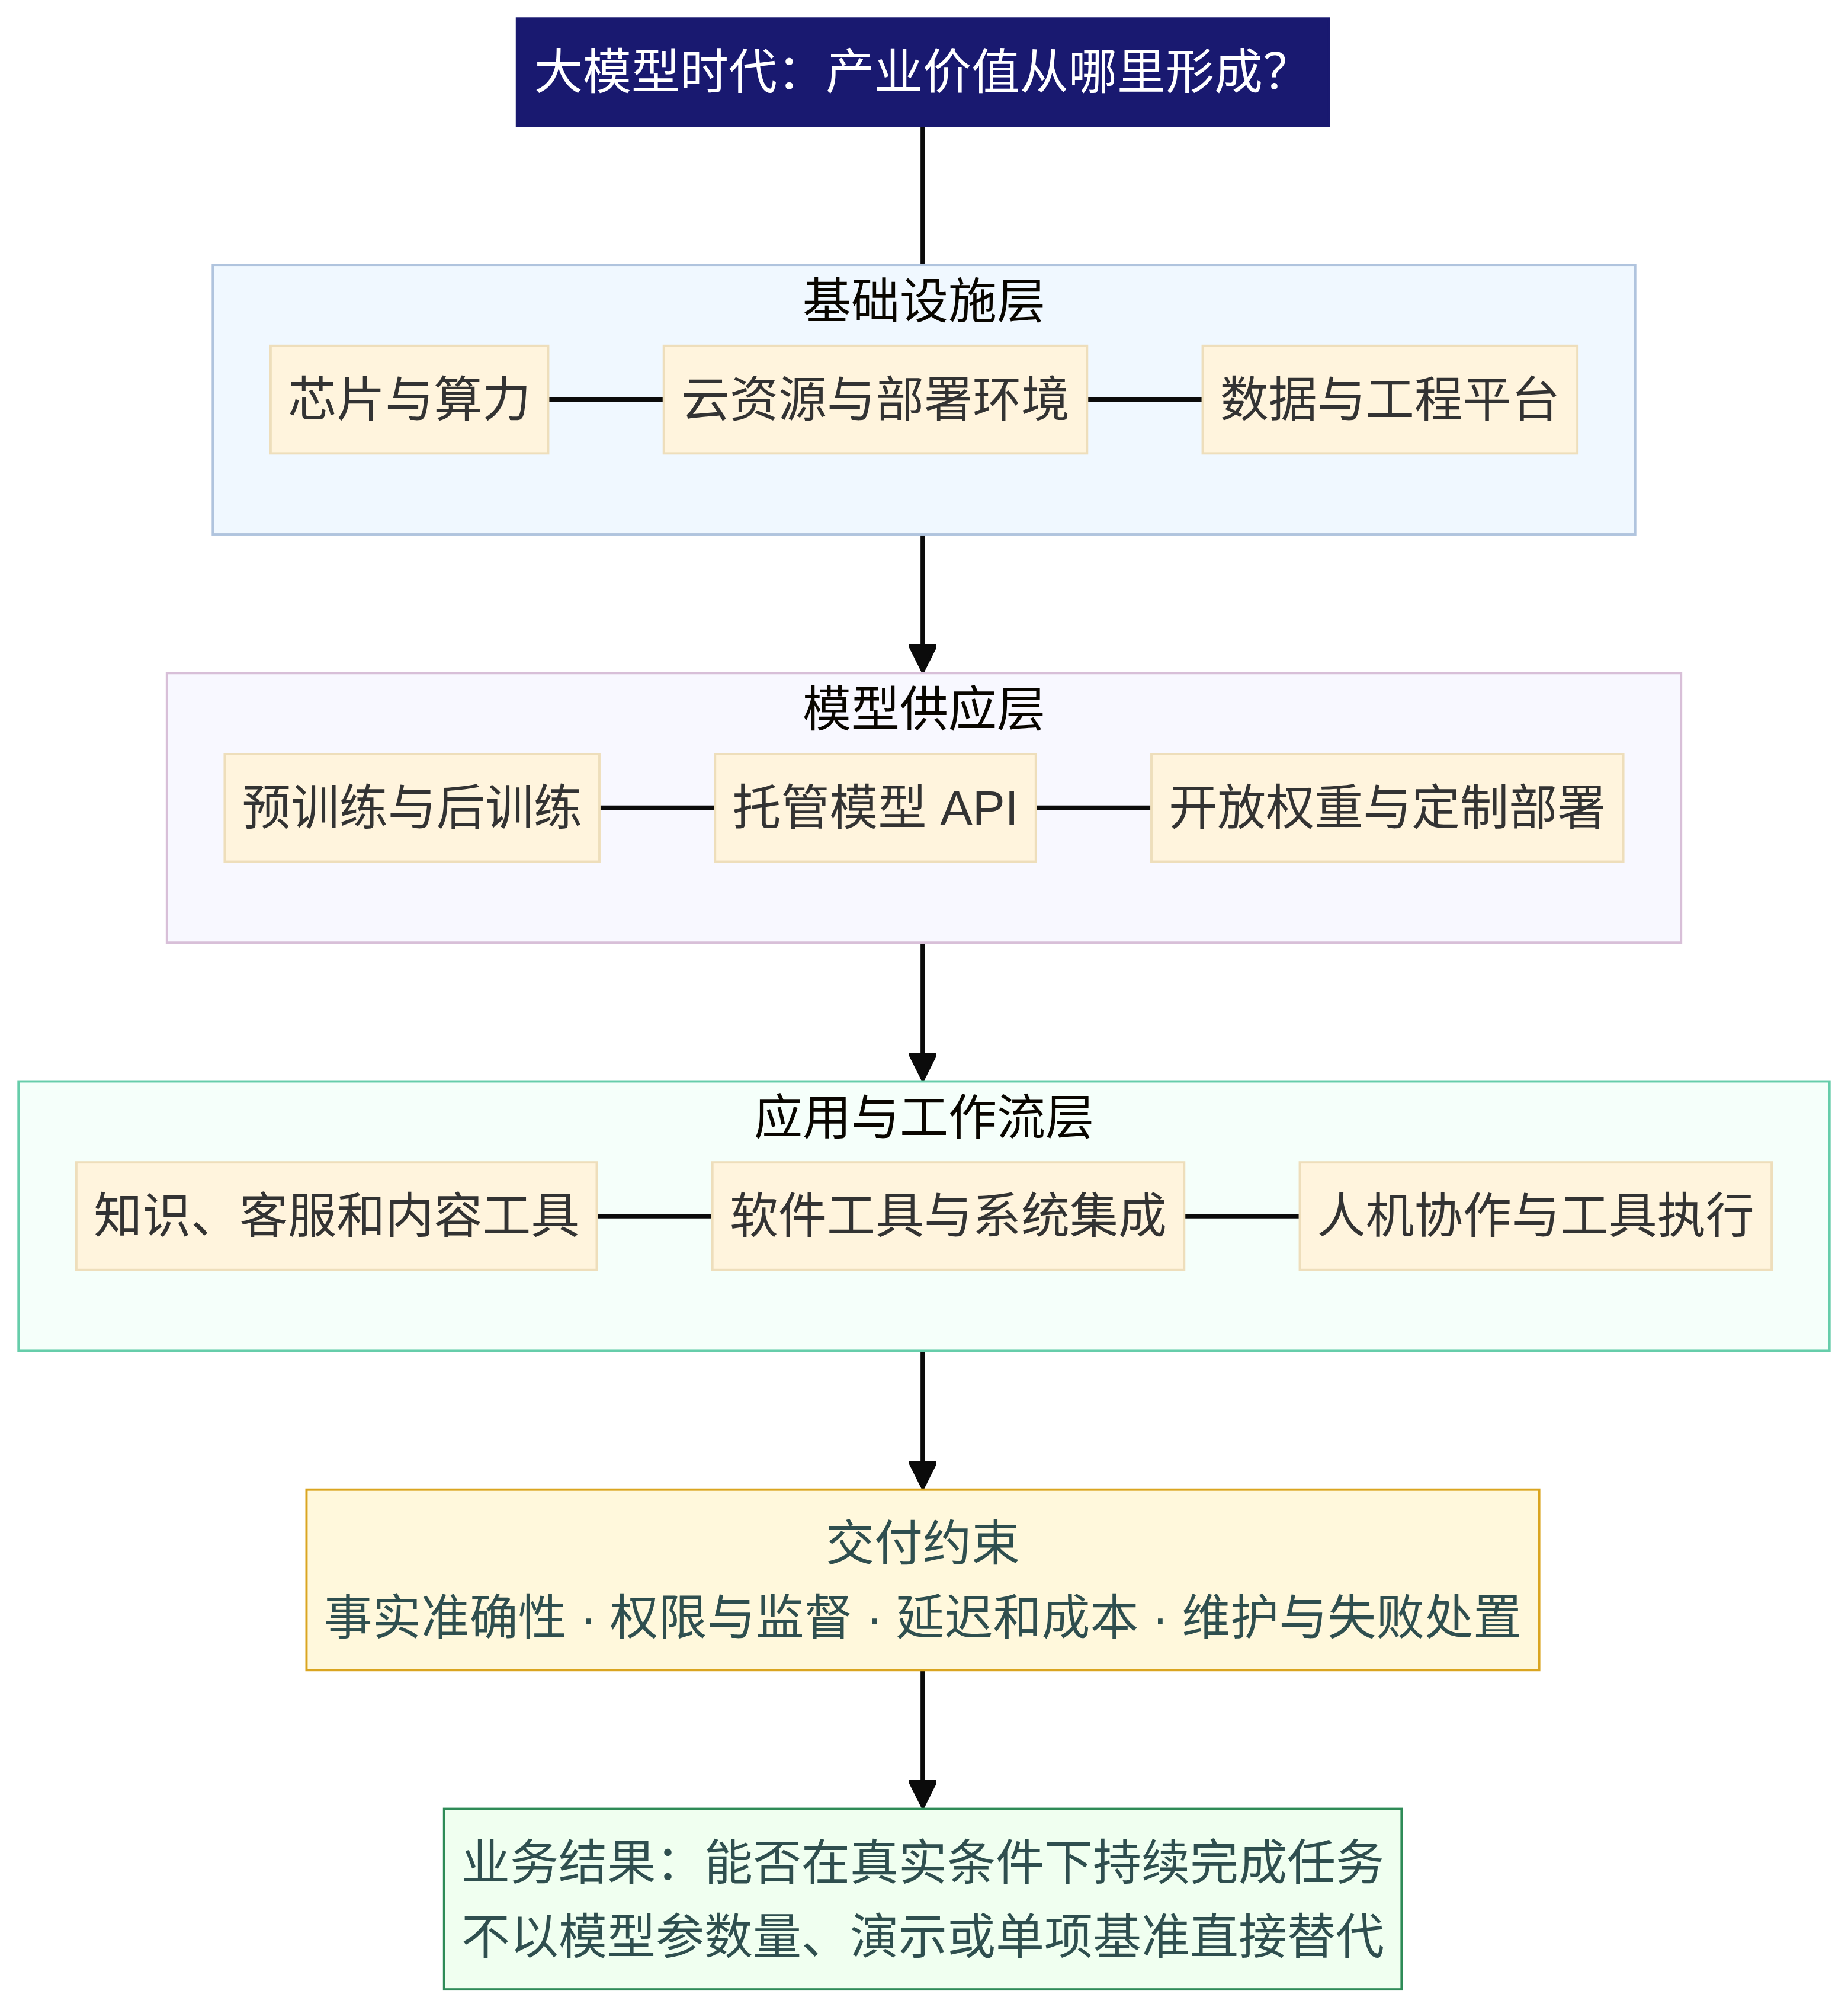
图 3|大模型时代的产业价值链示意。箭头表示从资源到模型、应用与业务交付的支撑关系,不表示市场份额、收入比例或每项技术的必经顺序;交付约束贯穿各层。[37] [44] [55] [62]
近期产品走向工具执行,但可靠交付仍有距离
已核实的近期产品材料延伸到 2026 年,而不是止于 ChatGPT 首发。OpenAI 的 2026 年 9 月 DevDay 发布记录包括持续运行代理、计算机操作 Agents API 和云端编程环境。不同产品处于指定套餐可用、预览或需管理员开启的 beta 等状态,显示商业形态正从回答问题扩展到托管执行和持续任务,而不是所有能力都已普遍开放。[57]
2026 年 10 月 17 日,DeepSeek 发布 V4.1-Flash-1017,官方称网站、应用和 API 已上线,并展示自反馈强化学习下的端到端项目案例。这能够证明当时的发布与公司演示,不能直接证明长流程无人自动化已在真实环境中普遍可靠。上述最新产品证据截至 2026 年 10 月 17 日,不应由整理日期推导出 11 月 14 日已有新的、未经核实的进展。[58]
产业扩张可以从资本和采用调查中观察,但数据年份必须清楚。2026 年 AI Index 经济章节统计的是 2025 年:全球 AI 私人投资约 3447 亿美元,其中生成式 AI 约 1709 亿美元。Quid 口径覆盖 2013 年以来融资超过 150 万美元的 AI 与机器学习公司,这不是行业收入,也不是全球全部 AI 支出。同章引用的 2025 年麦肯锡自报调查中,88% 受访者称组织至少一个职能使用 AI,79% 称定期使用生成式 AI;它不是全球企业普查,更不是 2026 全年采用率。[59]
真实部署已有比演示更具体的证据。2023 年的 NBER 工作论文研究 5179 名客服人员,主要上线时期为 2020 年 11 月至 2021 年 2 月,AI 提供建议,由员工自主决定是否采纳。论文报告每小时解决问题数平均提高约 14%。它支持边界明确的人机协作能够改善生产率,不支持“AI 已经自主替代客服”,也不能外推为 2026 年全行业效果。[60]
基准进步同样需要放回任务条件。2026 年 AI Index 记录,2025 年最佳模型在 OSWorld 的成功率为 66.3%,人类基线为 72.35%;该基准包含 369 项桌面与网页任务。这衡量特定测试中的计算机操作能力,不是现实办公自动化的通用可靠率,尤其不能直接推断多步骤任务在不同软件、数据和权限条件下的成功概率。[61]
落地限制因而不只是“模型还会答错”。NIST 的生成式 AI 风险框架指出,自信但错误的内容、来源问题和部署条件差异都需要评估,考试、零散案例及实验室测试不能保证真实部署可靠性。对于能够调用工具的系统,这意味着还要处理访问权限、人类监督、来源核查和失败处置,才能把模型输出变成可托付的业务结果。[62]
训练数据的使用也带来治理成本。美国版权局 2025 年的生成式 AI 训练预发表报告,按用途、作品性质、使用量和市场影响逐案分析合理使用,不能归纳成所有训练当然合法或当然侵权。它是美国特定法律背景下的分析,不是全球统一法律或法院判决。[63]
从知识获取到可靠交付:贯穿五阶段的产业变化
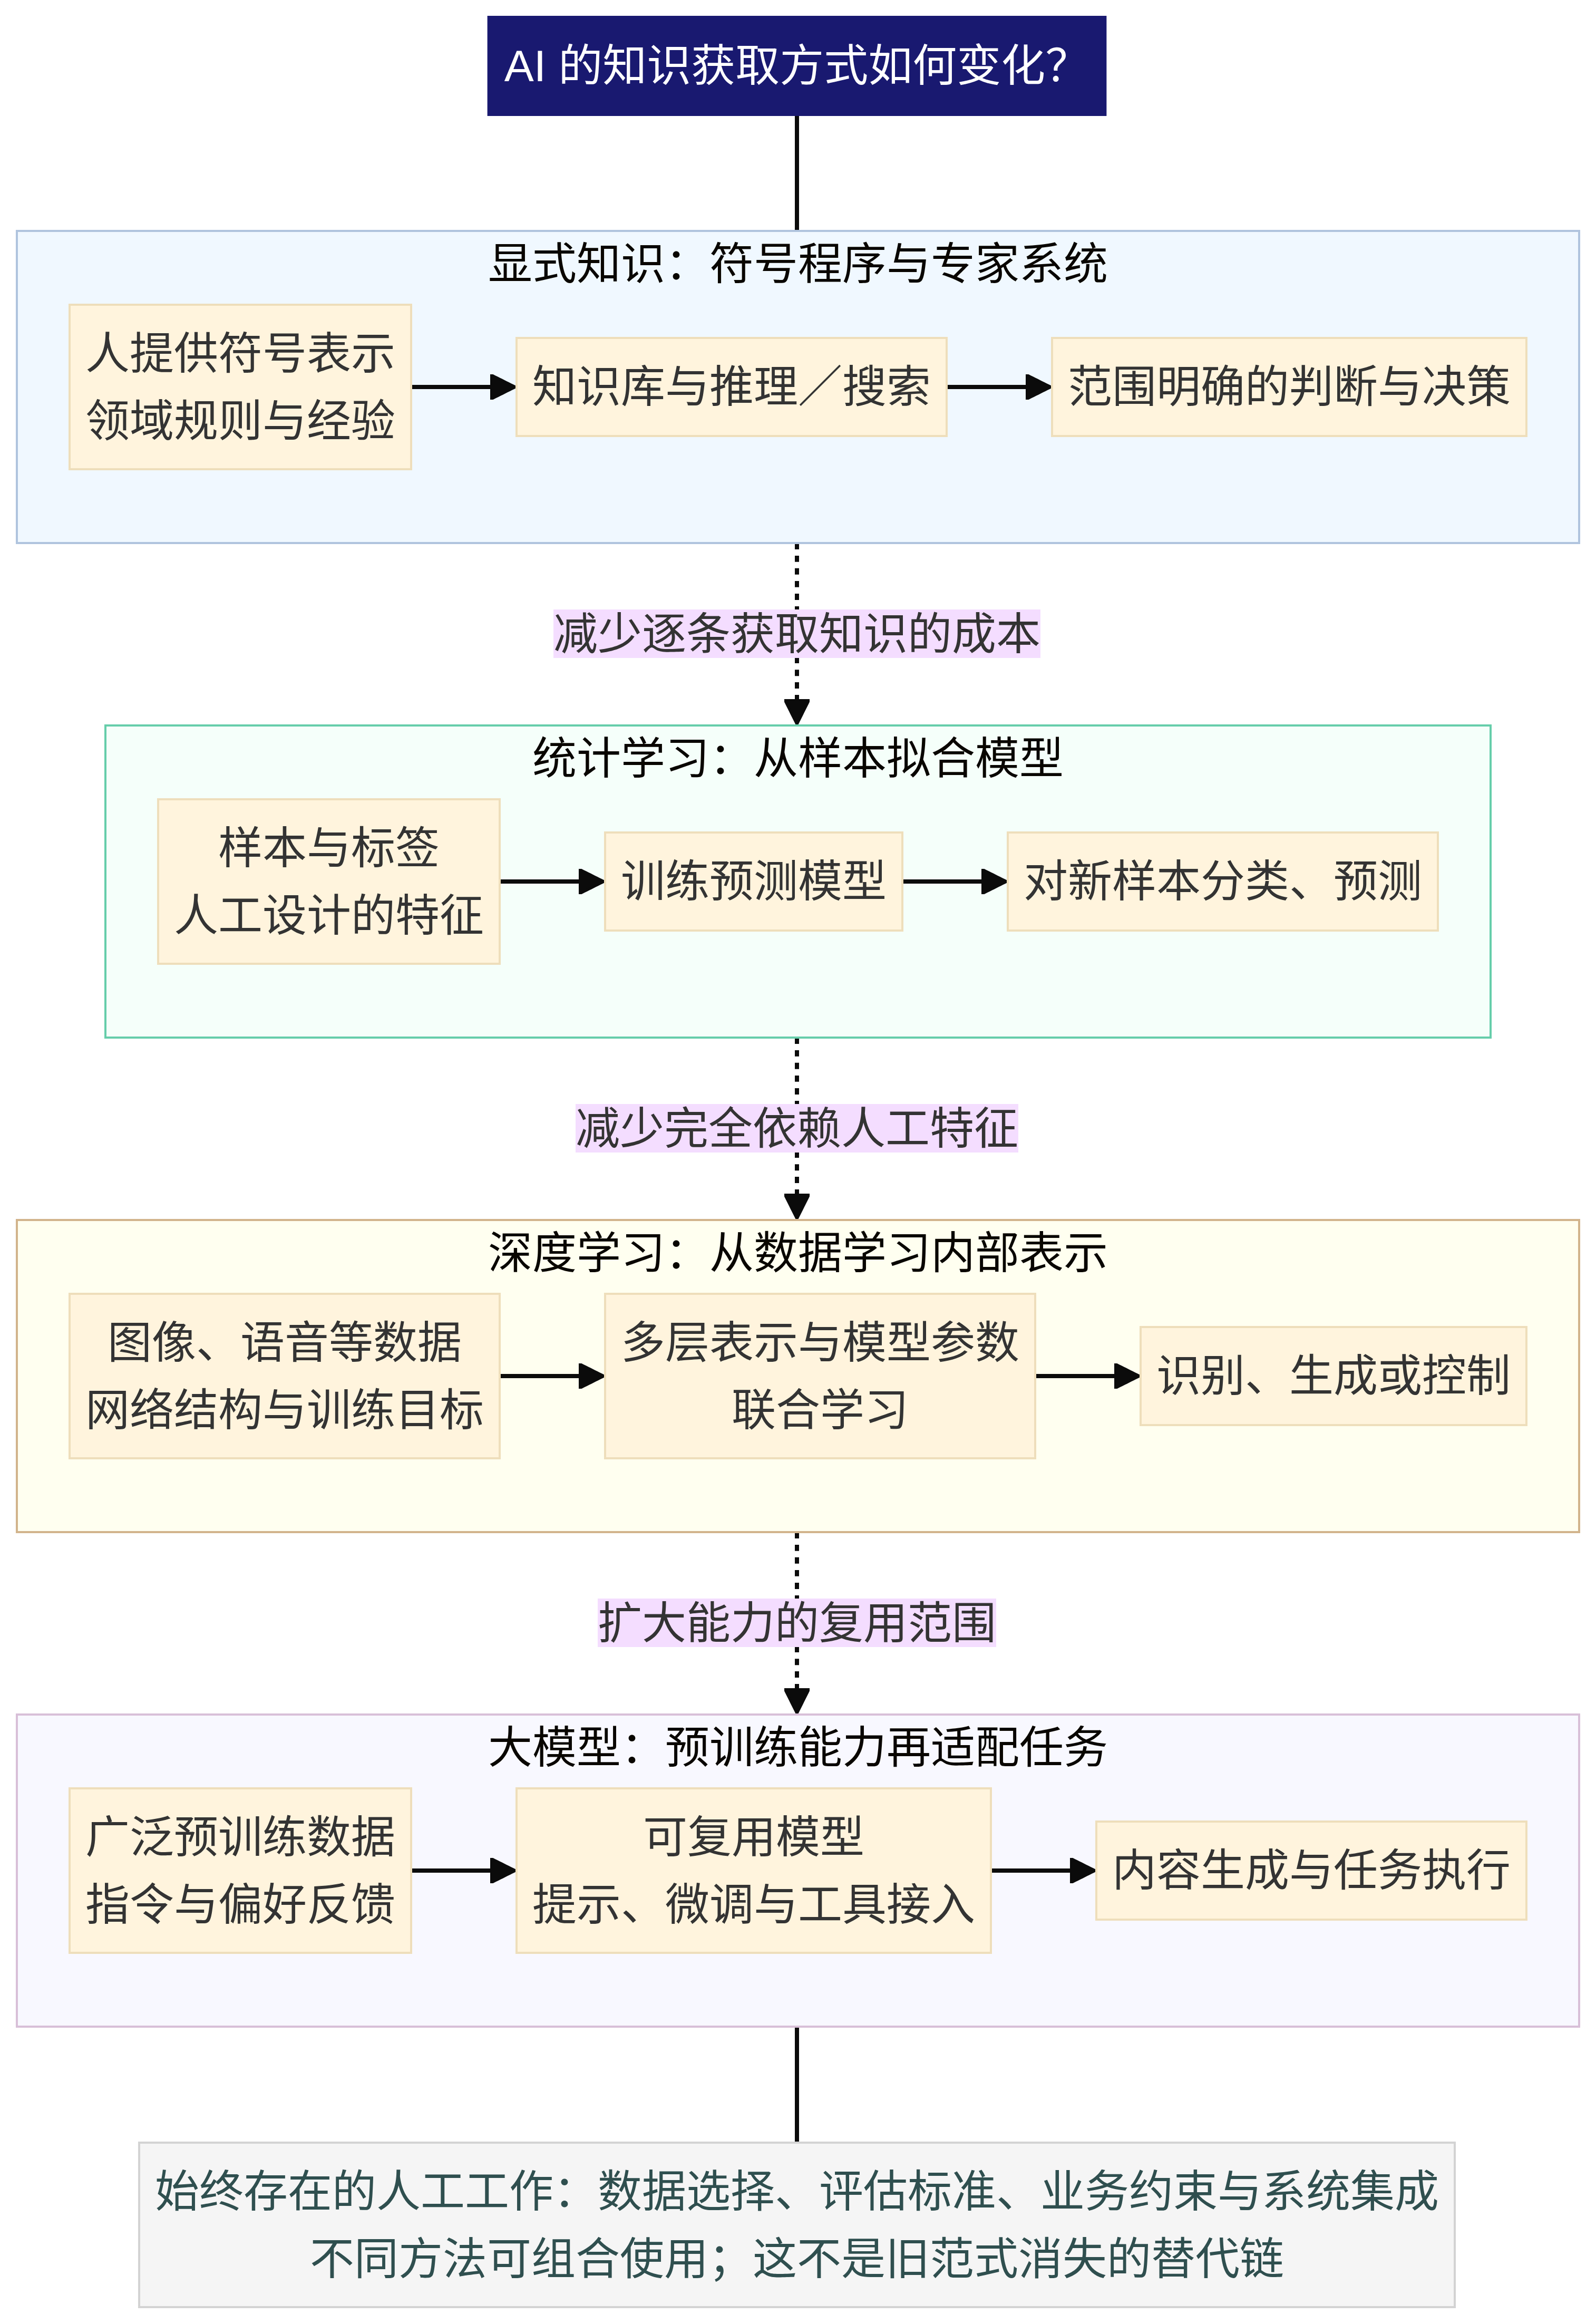
图 4|知识获取方式的演进。实线表示各类方法的典型处理流程,虚线概括向后续方法发展的动因;它是技术主线的归纳,不表示旧方法被完全替代。[12] [19] [30] [43]
综合上述历史,可以把知识获取方式的变化视为一条主线,但这是一种分析归纳,而不是所有技术必然依次替换的定律。符号程序和专家系统主要依靠人明确提供表示、规则与领域经验;机器学习把更多知识获取转为样本拟合;深度学习进一步学习内部表示;大模型则通过广泛预训练形成可复用能力,再用指令、微调和工具接入适配任务。人工知识没有消失,它继续存在于数据标注、评估标准、业务约束和工具设计中。Deep Blue、AlphaGo 及企业应用都提示,学习和显式结构可以共同发挥作用。
商业价值也从专用系统交付,扩展为基础设施、模型供应与应用工作流的组合。XCON 的价值依赖订单和制造流程;互联网推荐与广告依赖持续数据服务;深度学习推动云计算和能力 API;大模型进一步提供预训练接口、部署组件与工具执行环境。这不是后一种商业模式自动高于前一种,而是不同任务的知识成本、运行成本和集成要求,形成了不同的价值位置。
评估的重心则需要从“在封闭任务里能做什么”,转向“在实际条件下能否持续交付”。定理证明、围棋比赛和图像竞赛可以清楚衡量特定能力,病例盲评却不等于临床部署,代理基准也不等于真实办公流程可靠性。随着系统能够生成内容并执行操作,评价更需要覆盖事实准确性、权限、延迟、维护与失败后果。AI 行业的发展因此不是一条线性必然进步史,而是一系列能力突破、应用试验和工程约束之间的调整;现有证据不足以把它写成通用人工智能已经实现的历史。
作者:云搜
整理日期:2026-11-15
References
- A. M. Turing — Computing Machinery and Intelligence, 1950
- John McCarthy et al. — A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 1955
- National Research Council — Funding a Revolution, Chapter 9: Development in Artificial Intelligence, 1999
- Allen Newell and Herbert A. Simon — The Logic Theory Machine: A Complex Information Processing System, 1956
- Peter Hart, Nils Nilsson and Bertram Raphael — A Formal Basis for the Heuristic Determination of Minimum Cost Paths, 1968
- Frank Rosenblatt — The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, 1958
- Marvin Minsky and Seymour Papert — Perceptrons, 1969 text in the 1988 expanded edition
- SRI International — Shakey the Robot
- James Lighthill — Artificial Intelligence: A General Survey, 1973
- Thomas Haigh — There Was No First AI Winter, 2023
- Robert Lindsay et al. — DENDRAL: A Case Study of the First Expert System for Scientific Hypothesis Formation, 1993
- Bruce G. Buchanan and Reid G. Smith — Fundamentals of Expert Systems, 1988
- Antimicrobial Selection by a Computer: A Blinded Evaluation by Infectious Diseases Experts, 1979
- Rule-Based Expert Systems, Chapter 32 — Human Engineering of Medical Expert Systems, 1984
- John McDermott — R1: An Expert in the Computer Systems Domain, 1980
- Virginia E. Barker and Dennis E. O’Connor — Expert Systems for Configuration at Digital: XCON and Beyond, 1989
- History of Symbolics Lisp Machines — Archived Recollections of Dan Weinreb
- Thomas Haigh — How the AI Boom Went Bust, 2024
- J. Ross Quinlan — C4.5: Programs for Machine Learning, 1993
- Corinna Cortes and Vladimir Vapnik — Support-Vector Networks, 1995
- Leo Breiman — Random Forests, 2001
- B. H. Juang and Lawrence R. Rabiner — Automatic Speech Recognition: A Brief History of the Technology Development, 2004 manuscript
- Christopher J. C. H. Watkins and Peter Dayan — Q-learning, 1992
- Murray Campbell, A. Joseph Hoane Jr. and Feng-Hsiung Hsu — Deep Blue, 2002
- Sergey Brin and Lawrence Page — The Anatomy of a Large-Scale Hypertextual Web Search Engine, 1998
- Google — Google Launches Self-Service Advertising Program, 2000
- Matthew Richardson, Ewa Dominowska and Robert Ragno — Predicting Clicks: Estimating the Click-Through Rate for New Ads, 2007
- Greg Linden, Brent Smith and Jeremy York — Amazon.com Recommendations: Item-to-Item Collaborative Filtering, 2003
- Geoffrey E. Hinton, Simon Osindero and Yee-Whye Teh — A Fast Learning Algorithm for Deep Belief Nets, 2006
- Yann LeCun, Yoshua Bengio and Geoffrey Hinton — Deep Learning, 2015
- ImageNet: A Large-Scale Hierarchical Image Database, CVPR 2009
- Alex Krizhevsky, Ilya Sutskever and Geoffrey E. Hinton — ImageNet Classification with Deep Convolutional Neural Networks, 2012
- Ian Goodfellow et al. — Generative Adversarial Nets, 2014
- David Silver et al. — Mastering the Game of Go with Deep Neural Networks and Tree Search, 2016
- Google DeepMind — AlphaGo
- AWS — New EC2 Instance Type: The Cluster GPU Instance, 2010
- Google Research — Machine Learning in the Cloud, with TensorFlow, 2016
- Mariusz Bojarski et al. — End to End Learning for Self-Driving Cars, 2016
- AWS — Amazon Elastic Inference: GPU-Powered Deep Learning Inference Acceleration, 2018
- Ashish Vaswani et al. — Attention Is All You Need, 2017
- OpenAI — Improving Language Understanding with Unsupervised Learning, 2018
- Jacob Devlin et al. — BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2018
- Tom Brown et al. — Language Models Are Few-Shot Learners, 2020
- OpenAI — OpenAI API, 2020
- Long Ouyang et al. — Training Language Models to Follow Instructions with Human Feedback, 2022
- OpenAI — Introducing ChatGPT, 2022
- Robin Rombach et al. — High-Resolution Image Synthesis with Latent Diffusion Models, 2021 initial version and CVPR 2022
- Stability AI — Stable Diffusion Public Release, 2022
- OpenAI — GPT-4 Technical Report, 2023
- OpenAI — Hello GPT-4o, 2024
- OpenAI — Learning to Reason with LLMs, 2024
- DeepSeek — DeepSeek-R1 Release, 2025-01-20
- DeepSeek-AI — DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025
- Qwen Team — Qwen3: Think Deeper, Act Faster, 2025
- OpenAI — Introducing gpt-oss, 2025
- Open Source Initiative — The Open Source AI Definition, Version 1.0
- OpenAI — DevDay 2026 Recap, 2026-09-29
- DeepSeek — DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real, 2026-10-17
- Stanford HAI — Artificial Intelligence Index Report 2026, Chapter 4: Economy, primarily 2025 data
- Erik Brynjolfsson, Danielle Li and Lindsey R. Raymond — Generative AI at Work, NBER Working Paper 31161, 2023
- Stanford HAI — Artificial Intelligence Index Report 2026
- NIST — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, 2024
- U.S. Copyright Office — Copyright and Artificial Intelligence, Part 3: Generative AI Training, Pre-Publication Version, 2025
- SRI — Meet Shakey the Robot, Historical Photograph and Project Introduction, 2021