聊天式AI研究平台:云搜浏览器
作者:keanying
日期:2026-11-12
主题:AI 研究平台、云端浏览器、多智能体、数据采集、证据链、产品设计与工程落地
最初,我们只是希望基于景区数据寻找公开讲解资料,整理 CSV 并写入 MySQL。随着内容从 80 条扩展到 3,951 条,任务开始需要稳定批次、来源追溯、增量去重、停止续做和数据库约束处理。问题随之变得清晰:如果这些工作不再是一次性的脚本任务,而是任何用户都能通过对话发起的持续服务,产品应该怎样设计?
本文把这段采集实践进一步展开为“云搜浏览器”的完整方案:用户首先看到一个聊天框,搜索、AI 浏览器、智能体调度、数据处理和报告生成在云端执行,需要观察浏览过程时,再在右侧展开阅览窗口。文章既解释产品布局,也讲清后端协议、证据模型、可靠执行、安全预算和分阶段实现。前期采集与文件交付已经发生;平台服务和界面仍是设计稿,本文不把方案、示例代码或概念图写成已经上线的能力。
目录
- 1. 一次讲解资料采集,暴露了哪些真实问题
- 2. 从行业爬虫到通用AI研究产品
- 3. 为什么用户首先看到的应该是聊天框
- 4. 对话如何组织计划、进度与成果
- 5. 右侧云端浏览器:阅览与执行必须分开
- 6. 四种工作模式与完整使用场景
- 7. 一个问题进入系统后,后端究竟做什么
- 8. 八个智能体如何分工与协作
- 9. 自动搜索如何找到真正可用的来源
- 10. AI浏览器如何观察、操作并确认结果
- 11. 多任务、多智能体与浏览器并发如何落地
- 12. 为什么停止、暂停和恢复是核心工程能力
- 13. 从来源元数据到真正的讲解内容
- 14. 用证据链连接字段、事实和来源
- 15. 数据模型:为什么不能只保存聊天记录
- 16. 数据清洗、去重与可复现分析
- 17. 报告生成:让每个重要结论回到资料与计算
- 18. 文件交付、六表映射和可选MySQL投递
- 19. 接口设计:把聊天、任务和阅览真正连接起来
- 20. 安全、版权与授权为什么必须进入执行链
- 21. 成本与容量:怎样避免无限搜索和预算失控
- 22. 从文档到产品的分阶段实施流程
- 23. 测试、监控、部署与故障处置
- 24. 这类产品真正应该交付什么
1. 一次讲解资料采集,暴露了哪些真实问题
这个产品设想并不是从“再做一个 AI 聊天界面”开始的。最初的需求非常具体:基于一份景区主档,寻找景区、景点和博物馆的公开讲解资料,把可以使用的内容整理成 CSV,再写入 MySQL。
乍看之下,这似乎是一个爬虫问题:准备对象名单,搜索相关页面,提取正文,然后导出文件。但当任务从几条样例扩大到多个批次时,真正需要解决的问题远不止“网页能不能打开”。
景区主档有 17,167 条记录。我们先选了 20 个公开资料较丰富的景区,产出 80 条内容;后续扩采产出 2,959 条,再一次续采产出 912 条。按当时封存的交付记录,累计形成 3,951 条内容,覆盖 292 个主档对象,关联 3,859 个不同来源 URL,涉及 955 个域名。
这些数字说明的是前期采集文件的规模,不是一个通用平台已经上线的证明。3,951 条正文是基于公开事实资料自行整理的内容,不是全部来源的原文全文,也不是 3,951 段真实录音 ASR 转写。它们通过了本地结构和关联检查,但这不等于每一条历史事实已经经过独立人工审计。
把这些口径讲清楚,是产品化的第一步。否则,数据量很容易被误读成覆盖率,来源链接容易被误读成证据,而一份结构检查通过的 CSV,也容易被误读成已经完成事实核验的数据集。
1.1 元数据齐全,不代表讲解内容已经齐全
采集过程中,我们曾先整理全量对象及其已知来源线索:景区编码、名称、地区、官网、平台链接、页面标题、访问状态和候选导览入口。这一步有价值,因为后续任务不再从一张空白名单开始。
但它还不是用户真正想要的内容。
用户关心的核心字段是 topic、guide_title、guide_text、original_excerpt和 excerpt_source_url。一个页面标题叫“景区介绍”,不能自动变成一条有内容的讲解记录。一个网址看起来像官方导览入口,也不能证明里面存在可以获取的音频或者转写。
来源目录解决“到哪里找”。正文读取解决“实际找到了什么”。结构化整理解决“这些内容如何成为业务可用数据”。三个阶段必须分别记录,不能因为第一步已经完成,就把后两步也算完成。
1.2 内容越多,越需要保留它是怎么来的
只有几条记录时,人可以打开链接逐条对照。扩展到几千条以后,靠记忆回答“这一段哪里来的”就不可靠了。
同一个景点可能在官网、政府文旅页面、新闻报道和旅游社区中出现。几篇文章可能来自同一机构转载,域名不同却并不独立。一个讲解段落可能引用多个页面,而其中某个高度或者年代,需要更细的出处才能支持。
因此,前期交付采用了内容、事实、来源和关系表分开保存的方式。它让“某条内容用了哪些资料”和“某个事实由哪条证据支持”有机会被单独查询,而不是只在正文末尾留一个网址。
这也是后来平台证据模型的起点:不能只让 AI 写出一段流畅文字,还要保存它基于哪些实际材料形成。
1.3 任务中断不是偶然,而是正常使用方式
用户会说“继续采集”,也会说“先停止,做完的先给我”。这不是异常需求,而是长任务的正常交互。
如果系统只支持一个脚本从头跑到尾,就会出现几个问题:停止之后不知道哪些成果已经正式保存,重新开始时重复处理已经交付的对象,后续文件覆盖前一批文件,甚至同一批次的内容在用户导入数据库以后继续变化。
前期项目逐步采用稳定批次交付:首批、扩采和续采分别封存。已经交付的历史不因为后续追加而改变,新批次独立去重和导出。这样的要求后来必须进入平台的任务状态、检查点和版本协议,不能继续依赖人工记住“上次给了哪些文件”。
1.4 文件生成与数据库写入是两件不同的事
CSV 校验通过,不代表 MySQL 一定能接收。目标库名与 DDL 中的库名不一致,表尚未建立,字段类型不一致,新增平台枚举超出旧 CHECK 约束,都会导致导入失败。
更复杂的情况是提交响应丢失:客户端不知道数据库到底已经提交,还是尚未提交。如果此时简单重跑,就可能重复写入或覆盖数据。
这说明交付不能只设置一个笼统的“成功”状态。文件生成、结构校验、目标预检、事务写入和提交对账,都需要各自明确的状态。用户可以先下载文件,不应该因为没有配置业务数据库就完全无法使用采集能力。
1.5 为什么这些问题需要产品化
单次任务中,人可以临时补一句说明,手工合并文件,再改一下脚本。但如果同样的问题每天出现,或者由不同用户同时提出,就需要稳定的系统行为。
需求要能被编译成可执行规格,来源要能真实读取,产物要能追溯,任务要能停止和续做,费用要有上限,文件要有固定版本。前台还必须把这些复杂机制变成普通用户可以理解的体验。
云搜浏览器的设计,就是从这些已经出现的工作问题出发,构建一个通用的 AI 研究与数据生产产品。前期采集和交付是实践基础,下面介绍的聊天平台、云端执行池和多智能体内核则是待开发的产品与工程方案。
2. 从行业爬虫到通用AI研究产品
如果只围绕景区名单继续增加脚本,最终可能得到一个功能更强的景区采集工具。这个方向有价值,但它不能自然解决其他研究任务。
有人需要机构官网的公开产品参数,有人需要对比一组公开研究文献,也有人只是想了解一个问题,并得到带来源的回答。后两类任务可能根本没有预先整理好的对象主档,也不需要固定六张业务表。
因此,通用平台的任务起点应当是“用户想解决什么问题、希望得到什么产物”,而不是“请先上传景区 ID”。
2.1 平台接收的是目标,而不只是URL
传统抓取接口通常要求调用者给出网址和提取规则。云搜浏览器还要接受另一类输入:用户知道想要的答案,却不知道资料在哪里。
例如,用户可以输入:“请研究某类公开技术方案的适用条件,给我一份带引用的比较报告。”系统需要先理解比较问题,再拆分研究子题,搜索资料,识别可用来源,最后组织结论。
用户也可以输入:“从这份机构名单里寻找官方网站,提取我指定的公开字段,导出表格。”这种任务则更重视对象身份、行粒度、字段类型和缺失值。
两类任务可以共用来源读取和证据能力,但输出门槛不同。不能因为研究任务没有实体列表就报错,也不能因为数据采集任务没有长篇报告提纲就拒绝执行。
2.2 通用内核、行业模板和连接器分开
通用内核负责需求理解、搜索规划、浏览、证据、抽取、分析、报告和执行控制。它不要求每条任务都出现 scenic_id,也不规定所有文本必须写成某个固定长度。
行业模板规定特定业务的字段与判断规则。景区模板可以描述景区与内部景点的关系,讲解内容的类型,以及年代、结构、文物和文化地位的核验要求。机构模板可以关注主体名称、官网、产品、地区和发布时间。模板可以复用,也可以按用户需求修改,但它不能自动授予来源访问或数据库写入权限。
连接器决定数据从哪里进入和最终到哪里交付。搜索接口、授权数据 API、文件解析、报告渲染和 MySQL 投递都可以有适配器,但不必让所有用户配置全部连接器。
这个拆分使平台能够扩展到不同主题,而不用为每个行业复制一个新的任务系统。
2.3 它不是一个只会答复的聊天机器人
普通聊天答复以文本为主要产物。云搜浏览器还需要形成可持续使用的资料、数据集和报告。
用户应该能够追问某个数值的来源,下载完整表格,查看缺失字段,修改报告要求,停止尚未完成的工作,或者在新任务中继续处理剩余对象。
这些能力不能仅靠把整段聊天记录重新交给模型实现。必须存在消息之外的任务状态、数据版本、来源修订和文件记录。
聊天是交互入口,不是唯一存储模型,更不是所有执行状态的真相。
2.4 它也不是一个任意远程浏览器
产品中的云端浏览器服务于研究任务。它在政策范围内自动搜索、导航、展开页面并读取内容,而不是把一个完全开放的远程 Chrome 控制权交给每个用户。
浏览器可以负责动态页面的实际读取,也可以配合批准的静态 HTTP 读取优化。是否使用浏览器由任务需要和执行政策决定,不能为了界面看起来有浏览器就重复访问所有静态页面。
同样,显示一个网页画面并不能证明事实已经核验。页面打开、正文读取、字段提取和证据接受,是不同的步骤。
2.5 产品能力如何组织,而不变成十二个菜单
完整后端需要会话与成果、需求编译、任务控制、浏览器、来源证据、数据处理、报告、模板与智能体、质量、连接交付、项目授权以及预算运维等十二个能力域。
这些是系统应当具有的能力,不是用户必须依次理解的十二个页面。
会话和成果聚合呈现为历史与个人文件。需求编译呈现为澄清问题和计划卡。任务控制呈现为阶段进度与停止按钮。证据呈现为引用和来源面板。数据与报告呈现为可预览的成果卡。
更复杂的模型配置、执行器健康、来源政策和连接器维护,进入独立管理端。普通用户不应该为提出一个研究问题,先学习任务队列或者数据库约束。
3. 为什么用户首先看到的应该是聊天框
当产品能力很多时,最容易出现的设计是把所有功能做成左侧菜单:任务、浏览器、资料、数据、报告、模板、审核、连接器、权限和系统设置。
这种布局有利于管理,却未必适合开始使用。一个刚进入产品的用户,最清楚的是“我想做什么”,而不是“这件事应该先去哪个模块”。
因此,默认首页应该给用户一个直接表达目标的位置。
3.1 首页的视觉中心只有一个
欢迎语可以是“你好,今天想探索什么?”下面是一句说明:从一个问题开始,让 AI 帮助搜索、整理数据和生成报告。
中间是居中的多行聊天输入框。附件、模式选择和发送控件与输入放在一起。下方可以有搜索问题、深入研究、采集数据和生成报告等快捷建议,底部再放最近对话、我的成果和常用模板。
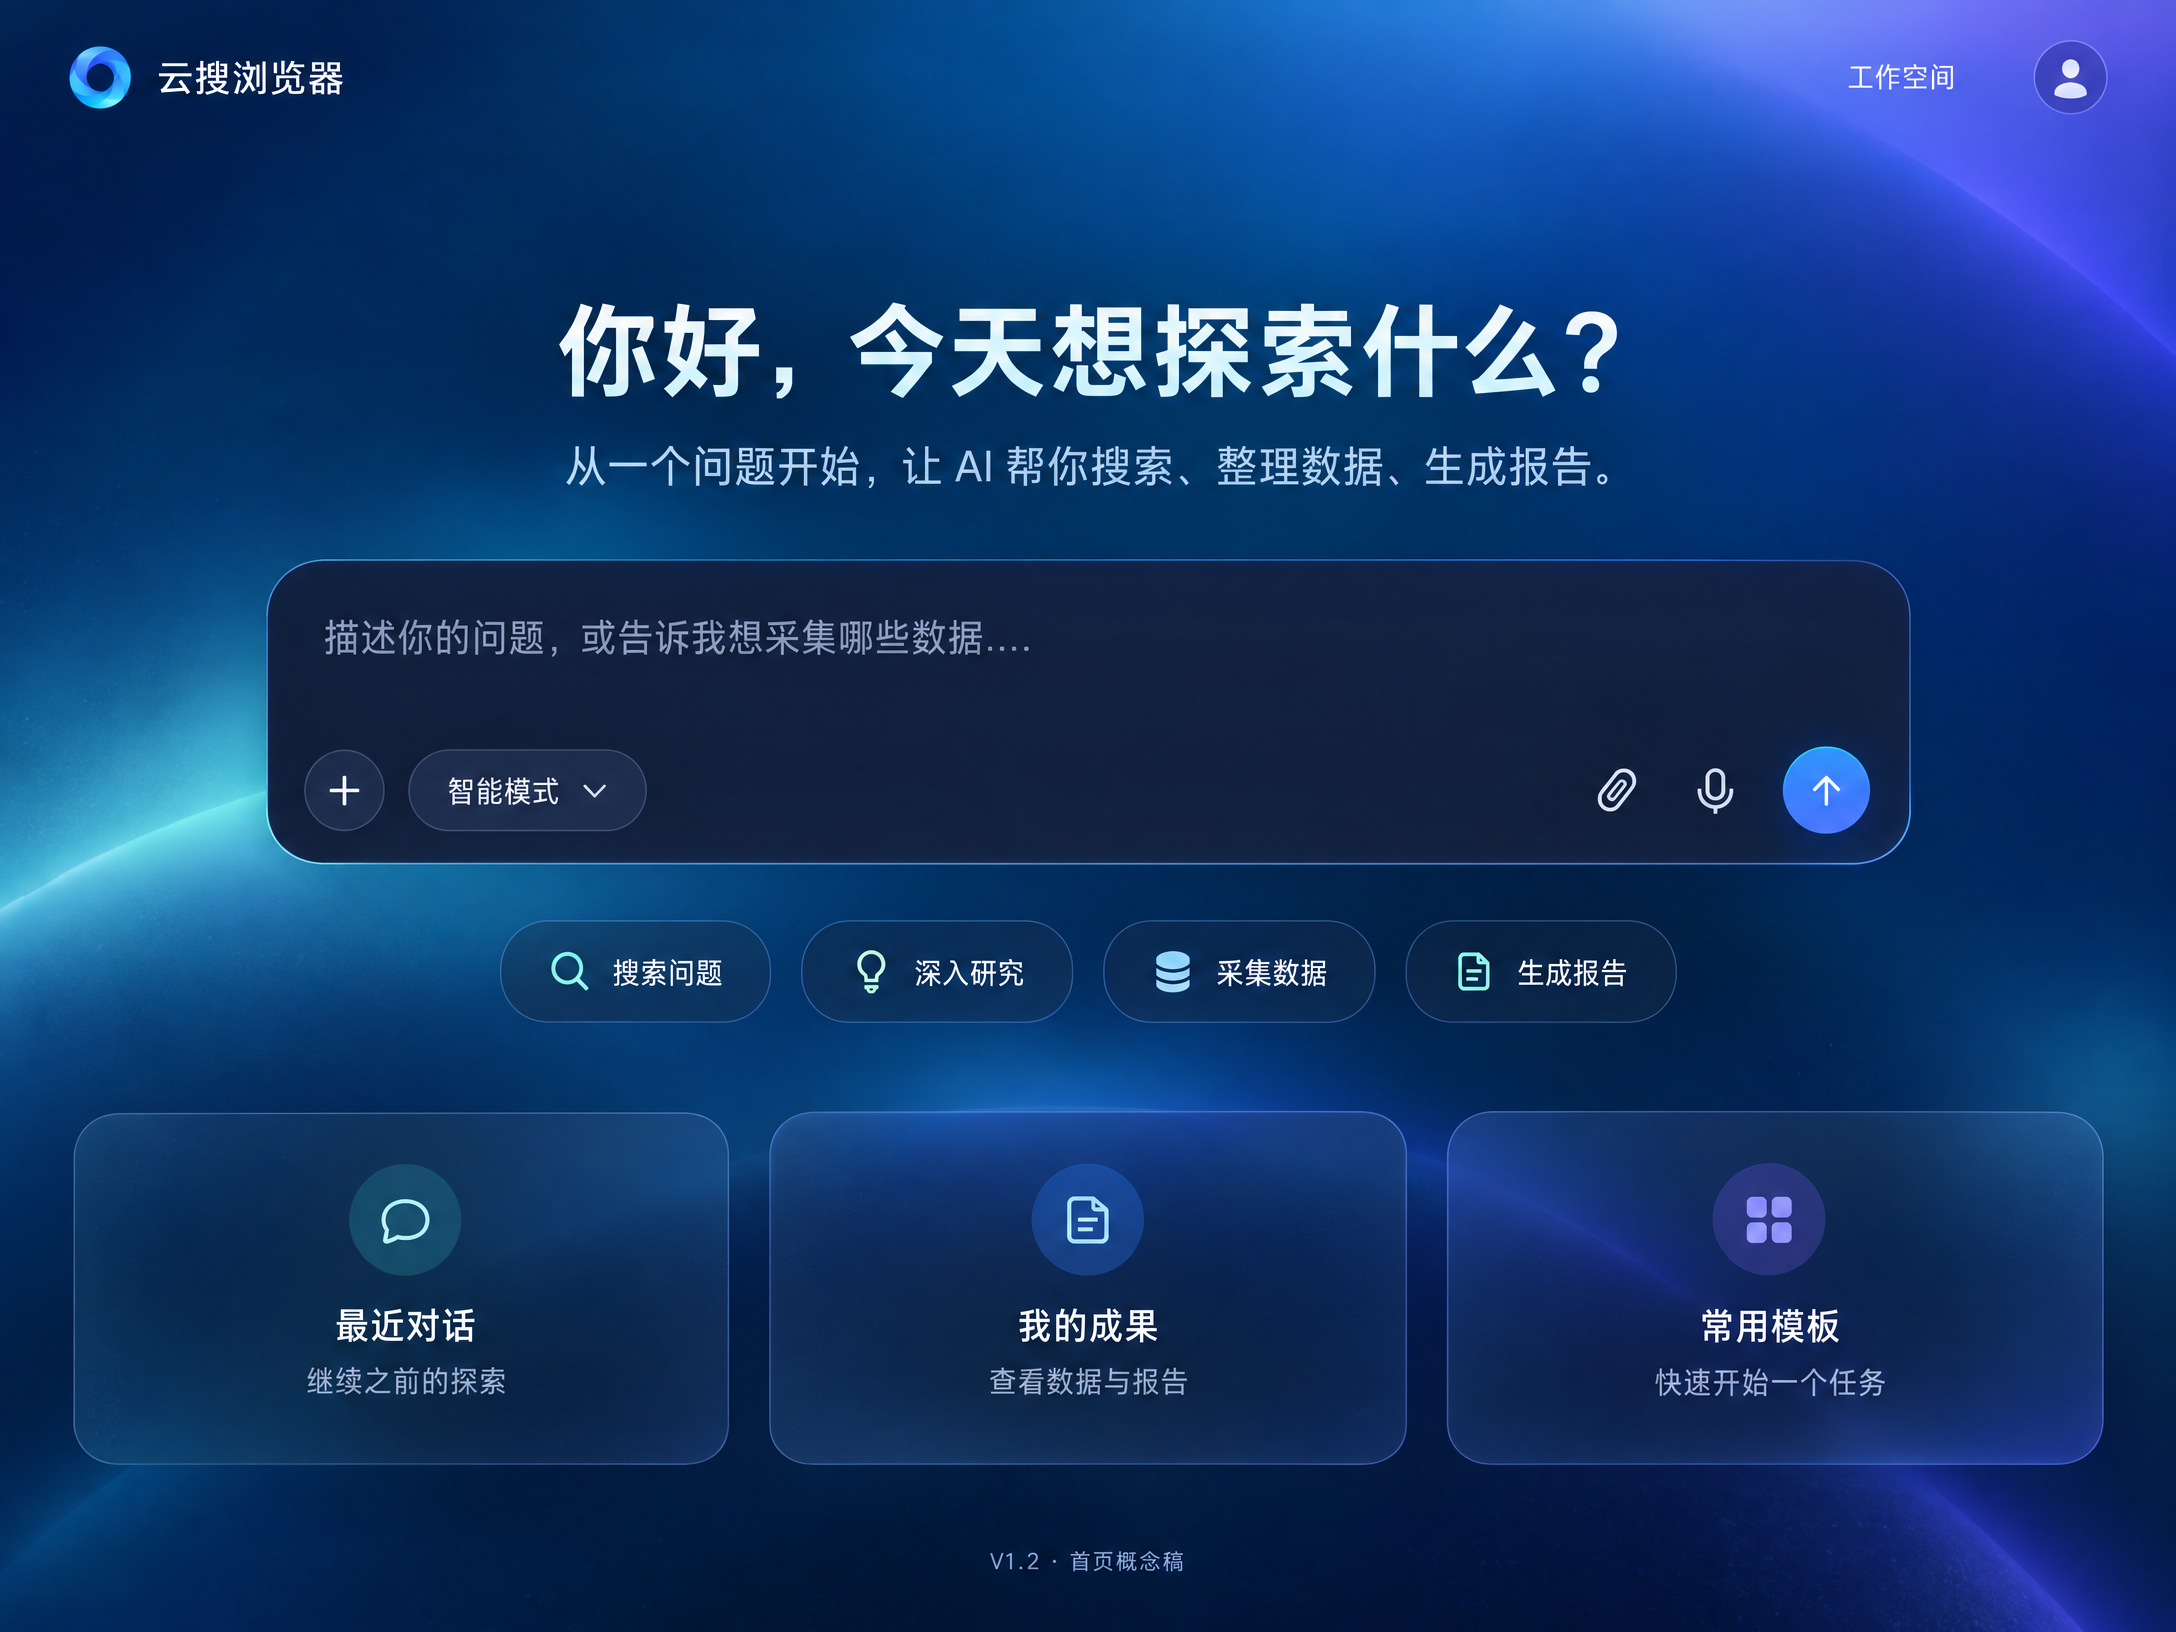
上图是 AI 生成的概念稿,不是正在运行的软件截图。图中的“工作空间”可以收敛为历史和成果的可选入口;麦克风是后续能力的视觉预留,第一期没有实现语音时应隐藏。卡片上的引导文字也是空态说明,不能用来暗示已经产生文件。
真正重要的不是深蓝配色,而是信息优先级:用户需求是第一位的,系统配置不是。
3.2 简单入口不等于没有约束
用户说“尽量多采一些”,系统仍然需要确定对象范围、资料类型、条数上限和预算。区别在于,这些条件可以通过对话逐步明确,而不是一开始给用户一张几十个字段的任务表单。
有些默认值可以来自项目政策,例如输出语言、允许来源和单次额度。有些必须由用户决定,例如要采集哪些对象,以及结果是内部研究还是对外发布。
系统应该说明默认值来自哪里。它不能把模型猜测的范围自动当成用户授权。
3.3 “智能模式”是一种交互策略
首页可以默认选择“智能模式”,让系统根据输入建议执行路线。用户需要时可以明确切换为搜索、研究、数据或者数据加报告。
这里有一个容易混淆的地方:智能模式不是第五种后端任务类型。它只是帮助决定是否需要任务,以及应该采用哪一种任务模式。
用户发送“你好”,不应该启动八个智能体和云端浏览器。用户说“打开刚才那个 CSV”,也不应该重新联网采集一遍。这样的区分既影响体验,也影响费用。
模式识别需要可以解释和覆盖。用户明确选择数据输出以后,系统不应悄悄变成长篇报告;需求改变导致费用显著增加时,应重新展示方案。
3.4 输入框需要处理真实输入,而不是只看起来漂亮
多行文本需要支持 Enter 发送和 Shift+Enter 换行。中文输入法处于候选组合阶段时,按 Enter 不能误发送。
附件上传要展示进度、解析状态和失败原因。发送之前,系统必须知道哪些文件已经获得授权并且可以处理,而不是用户选择了文件就立即假定读取成功。
长内容可以让输入框适度增高,但不能挤掉全部对话阅读空间。模式选择和附件操作应该能通过键盘完成,并有明确的可访问标签。
这些细节看似只是前端问题,实际上会直接影响任务是否被重复创建,或者用户未完成的输入是否被意外提交。
3.5 空态和历史要保持真实
没有历史对话,就显示没有历史。没有成果,就告诉用户数据和报告会在这里出现。不能为了演示漂亮而在正式用户界面放几份看似已经生成的文件。
最近对话和个人成果必须来自当前项目的真实授权范围。切换项目后,旧项目的私密标题不应继续出现在首页卡片里。
用户可以建立新对话,但建立新对话不代表停止以前的云端任务。正在执行的工作可以通过轻量后台任务摘要保留控制入口,不必占据整个首页。
4. 对话如何组织计划、进度与成果
首页发送第一条消息后,界面应从欢迎页变成持续的对话工作区。输入框移到下方,聊天内容成为主区域,右侧面板默认仍然关闭。
一个好的聊天式研究产品,不只是把传统表单藏起来。它需要把计划、澄清、运行状态和文件变成有明确行为的消息结构。
4.1 一条助手消息可以包含多种片段
普通解释是文本片段。需要补充范围时是澄清片段。执行前的摘要是计划片段。真正的后台阶段是进度片段。来源是引用片段。数据文件和报告是成果片段。敏感操作则是授权片段。
它们可以出现在同一轮对话中,但不能都当作一段模型生成的文字保存。
例如,成果片段应引用一个真正存在的 artifact_id和文件版本,而不是模型随意写一个下载链接。进度片段应引用真实任务事件,而不是模型说“已经完成了 80%”。
模型可以帮助生成容易理解的描述,但状态本身应当来自系统。
4.2 什么时候自动执行,什么时候先确认
如果问题清楚,任务风险低,来源政策和预算已经批准,发送后可以直接开始。用户不应为每次搜索或者每次打开公开页面重复点击确认。
如果关键条件缺失,则应在对话中集中澄清。比如“采集博物馆讲解”还没有指定对象和范围,系统可以提出一个有限建议,再请用户确认。
如果用户要求增加对象、改用途、扩大额度,或者写入外部数据库,就需要按实际变更重新确认。确认必须绑定精确计划版本,不能“批准过一次”就允许后端以后无限扩展。
把高风险判断放在执行政策中,比单纯依赖模型在文字里说“我会注意安全”可靠。
4.3 计划应该让人看懂,而不是展示完整DAG
后台可能生成包含许多工作项和依赖的有向无环图,也就是 DAG。用户不需要在聊天里读完所有节点。
前台可以呈现三个或者几个明确阶段:确认范围与字段,搜索并读取资料,核验并整理,生成文件。用户需要时展开详细范围、来源策略和预计资源上限。
但简化展示不意味着计划可以含糊。后台仍需要知道对象数量、可补查次数、每个字段的要求、文件类型和终止条件。
用户修改计划时,要形成新版本。新确认不能与旧计划的哈希混用。
4.4 进度必须从持久事件产生
如果后端只是完成搜索候选发现,前台不能显示“资料核验完成”。只有正文正式保存后,才能说“已读取来源”;只有计算真正运行成功后,才能说“已完成分析”;只有文件封存后,才能给出可下载成果。
没有稳定总量的时候,就不要给一个看似精确的百分比。可以展示当前阶段、已处理数量、已知范围和剩余缺口。
来源无法访问,也应该作为正常情况显示:需要登录、许可不足、没有对应字段或者页面解析失败。不能把所有情况都写成“正在努力搜索”,让用户无止境等待。
这里展示的是可验证的执行摘要,不是模型的隐藏推理过程。
4.5 用户追问时,先判断是否需要新执行
“把上面结论简化一点”通常只需要改呈现。“这条高度的出处是什么”可以读取已有证据。“再加一个尚未采集的属性”则可能需要补查。
系统不能每次追问都重启整个任务,也不能把需要新资料的问题仅靠旧聊天记忆回答。
运行中的范围内补查可以依计划和剩余额度展开。一个任务已经结束后,用户要继续处理,应该建立关联的新任务,而不是把已下载的旧文件悄悄替换。
因此,会话可以承载多个任务,任务也可以被授权的多个会话引用。当前轮的控制范围必须清楚,不能把一个会话所有历史工作绑成一个不可分割的运行实例。
4.6 成果不应该只能在聊天气泡里阅读
数据可以是分页表格,报告可以是可引用文档,来源可以是结构化资料卡。它们适合在右侧按需面板中打开,同时保留左侧对话。
数据预览应该说明显示的是样本还是全量,以及对应哪个固定版本。用户点击某个单元格,应当能够看到原始值、标准化值、缺失原因和来源证据。
报告预览应绑定具体修订。点击引用,要回到当时使用的资料版本和必要证据,而不是自动跳到已经改变内容的“最新网页”。
如果文件被撤权、过期或者删除,要说明不可用。不能为了保持界面链接可点,就替换成另一个未明确告知的版本。
4.7 离开页面与停止任务必须区分
用户关闭标签页,云端任务可以继续。返回时按已保存事件恢复对话和成果,而不是从头采集。
用户点击“停止当前轮”,则应向后端提交明确任务集合的停止命令。前台先显示命令已受理,再显示后台是否到达停止状态。按钮变成“已停止”,并不意味着远端执行已经真的停止。
停止应保留已经正式提交的成果,展示部分交付与缺口。未完成内容可以以后新建任务继续。这样,聊天才能真正控制工作,而不是只控制动画。
5. 右侧云端浏览器:阅览与执行必须分开
右侧浏览器是整个产品最容易被误解的部分。
它不是用户必须打开的工具,也不是唯一执行线程,更不应默认成为一个任意导航和点击的远程桌面。它首先是对后端云端浏览器会话的阅览窗口。
5.1 后端创建浏览器,用户按需看画面
一个任务需要动态页面读取时,后端自动检查浏览器服务健康,创建或分配受控会话,然后执行搜索、导航和内容读取。
这一过程不依赖用户是否展开右侧窗口。否则,用户不开窗口就无法采集,产品又会退回手工浏览工具。
点击“查看浏览器”只是申请查看当前任务已有的会话。没有会话时,就显示尚未启动;当前步骤不需要浏览器时,也可以说明原因。不能为了填满一个面板,另外创建无关浏览器并产生额外费用。
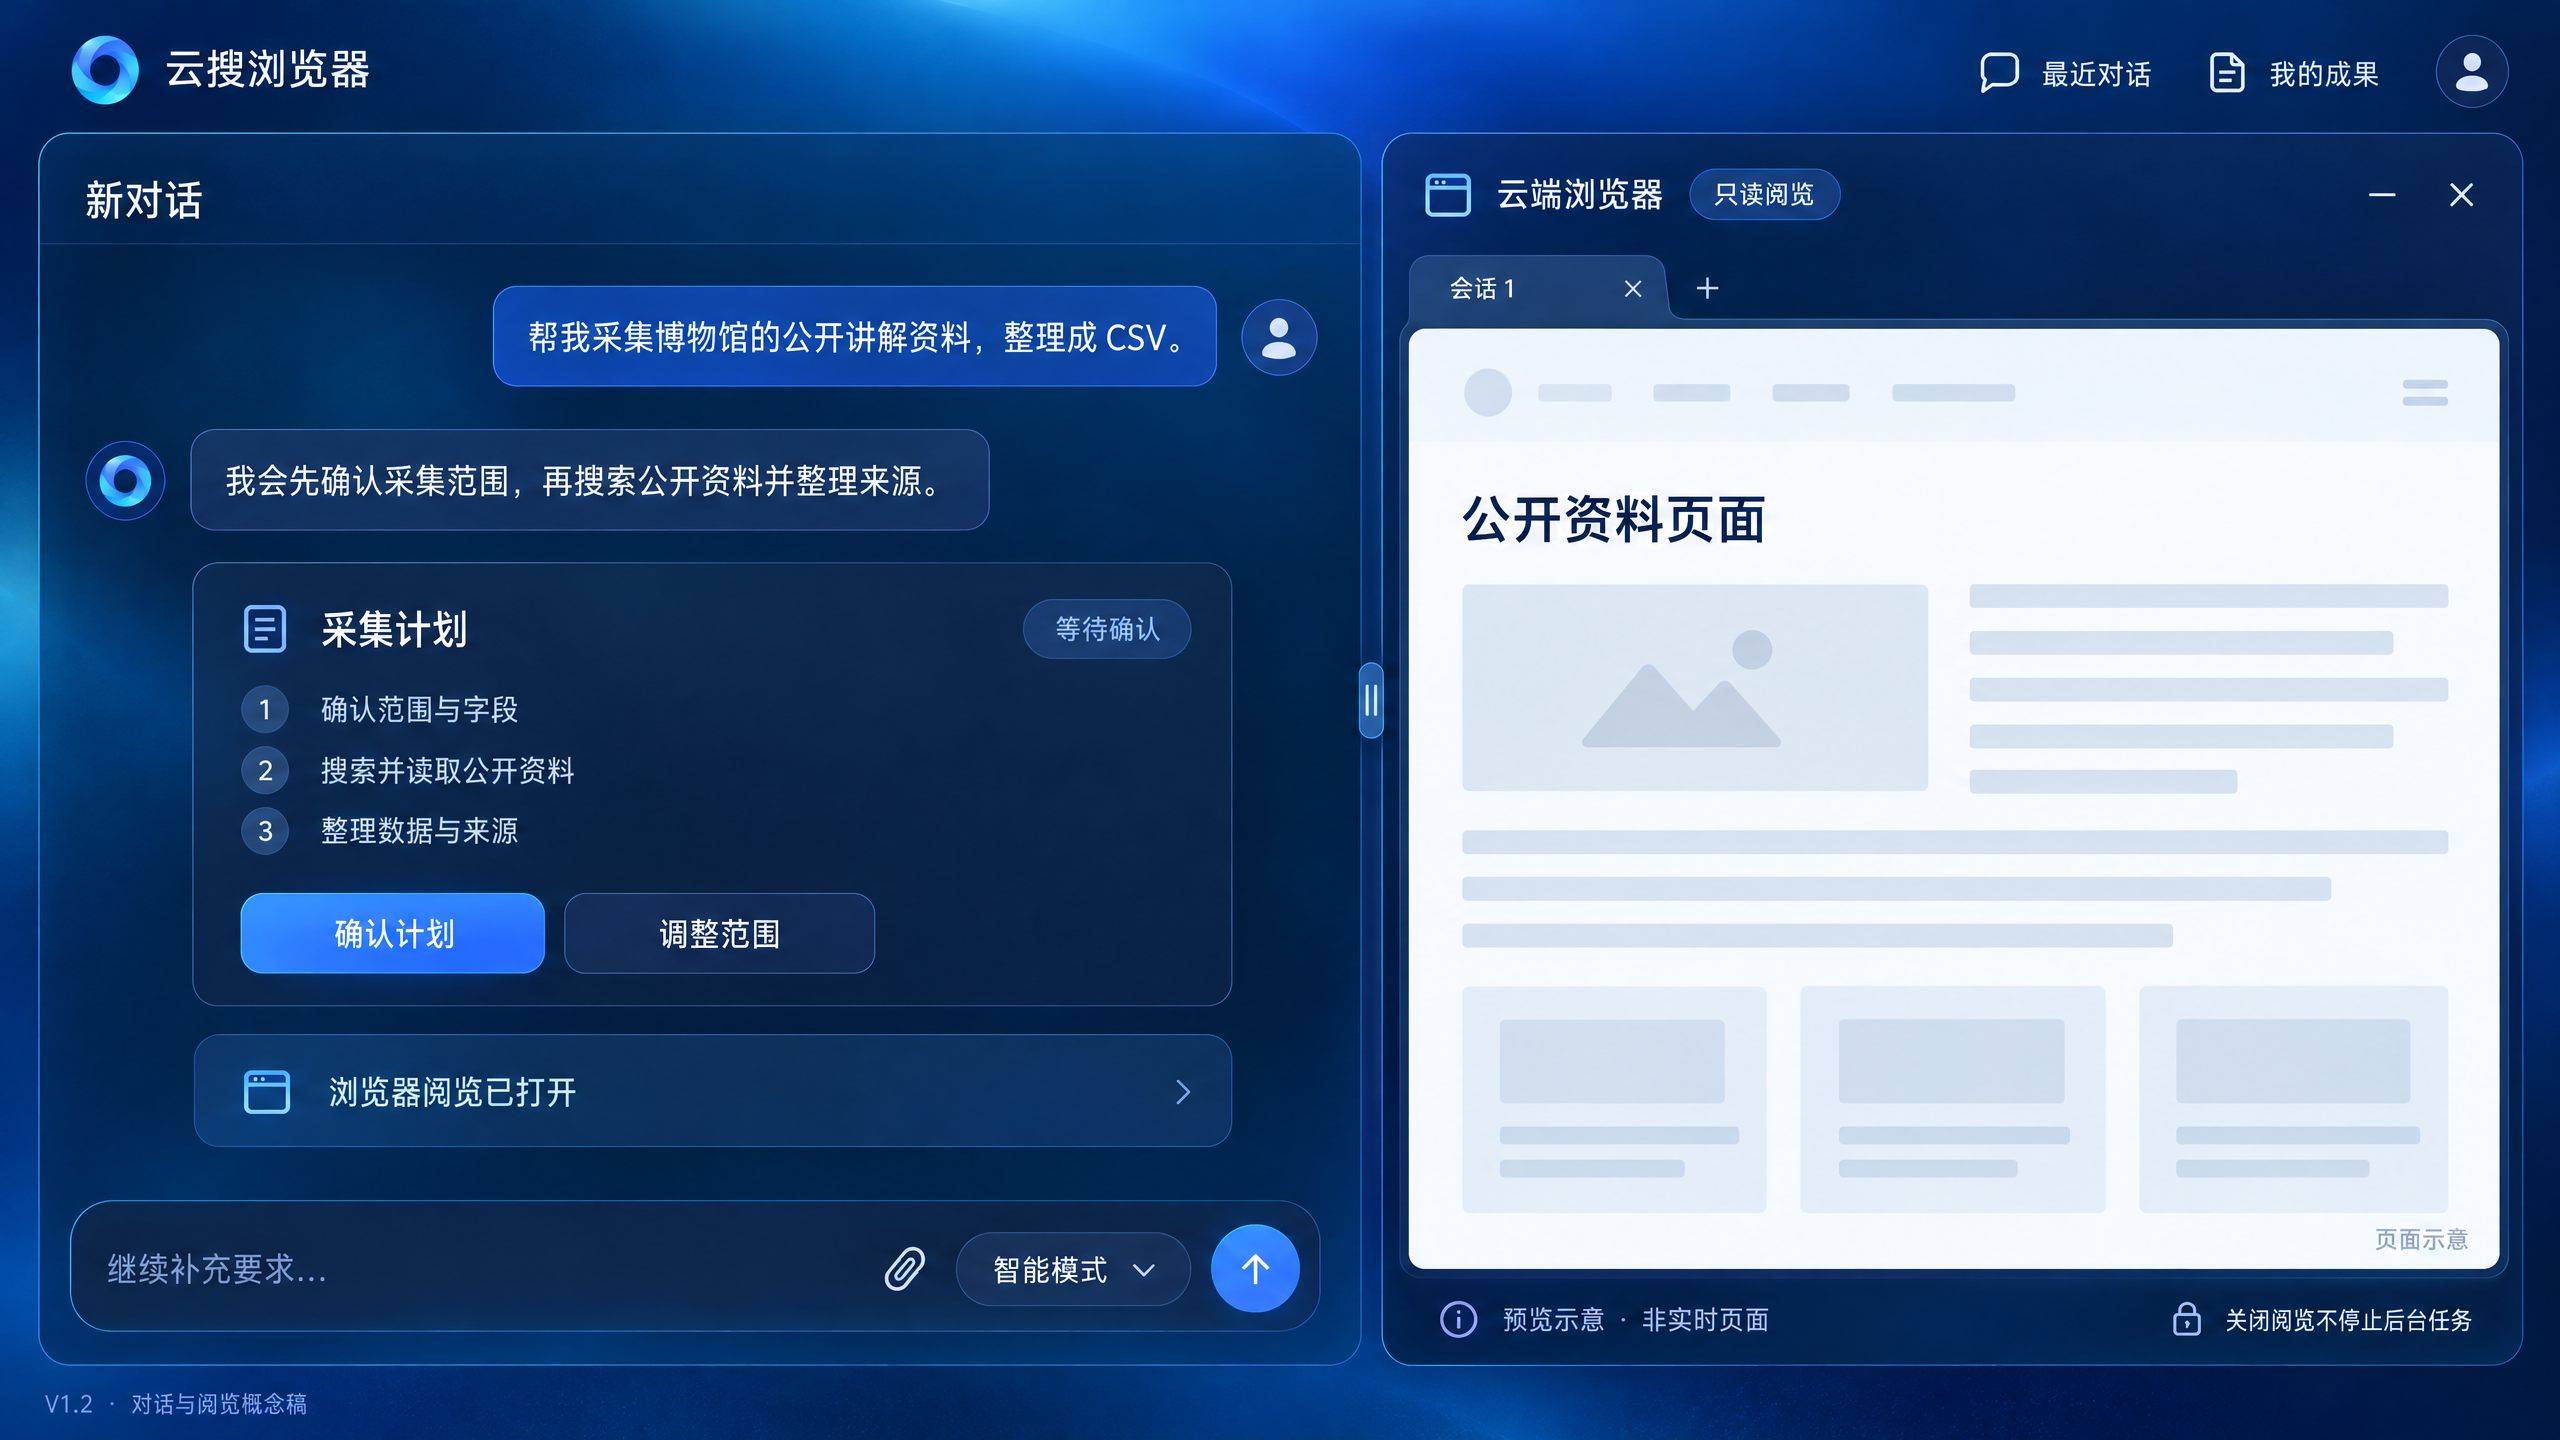
图中的网页是界面示意,不是真实来源;标签区加号只表示可选会话查看的视觉结构,不代表允许用户任意新建执行会话。正式实现要根据真实后台状态决定哪些会话可阅览。
5.2 六种操作必须有不同语义
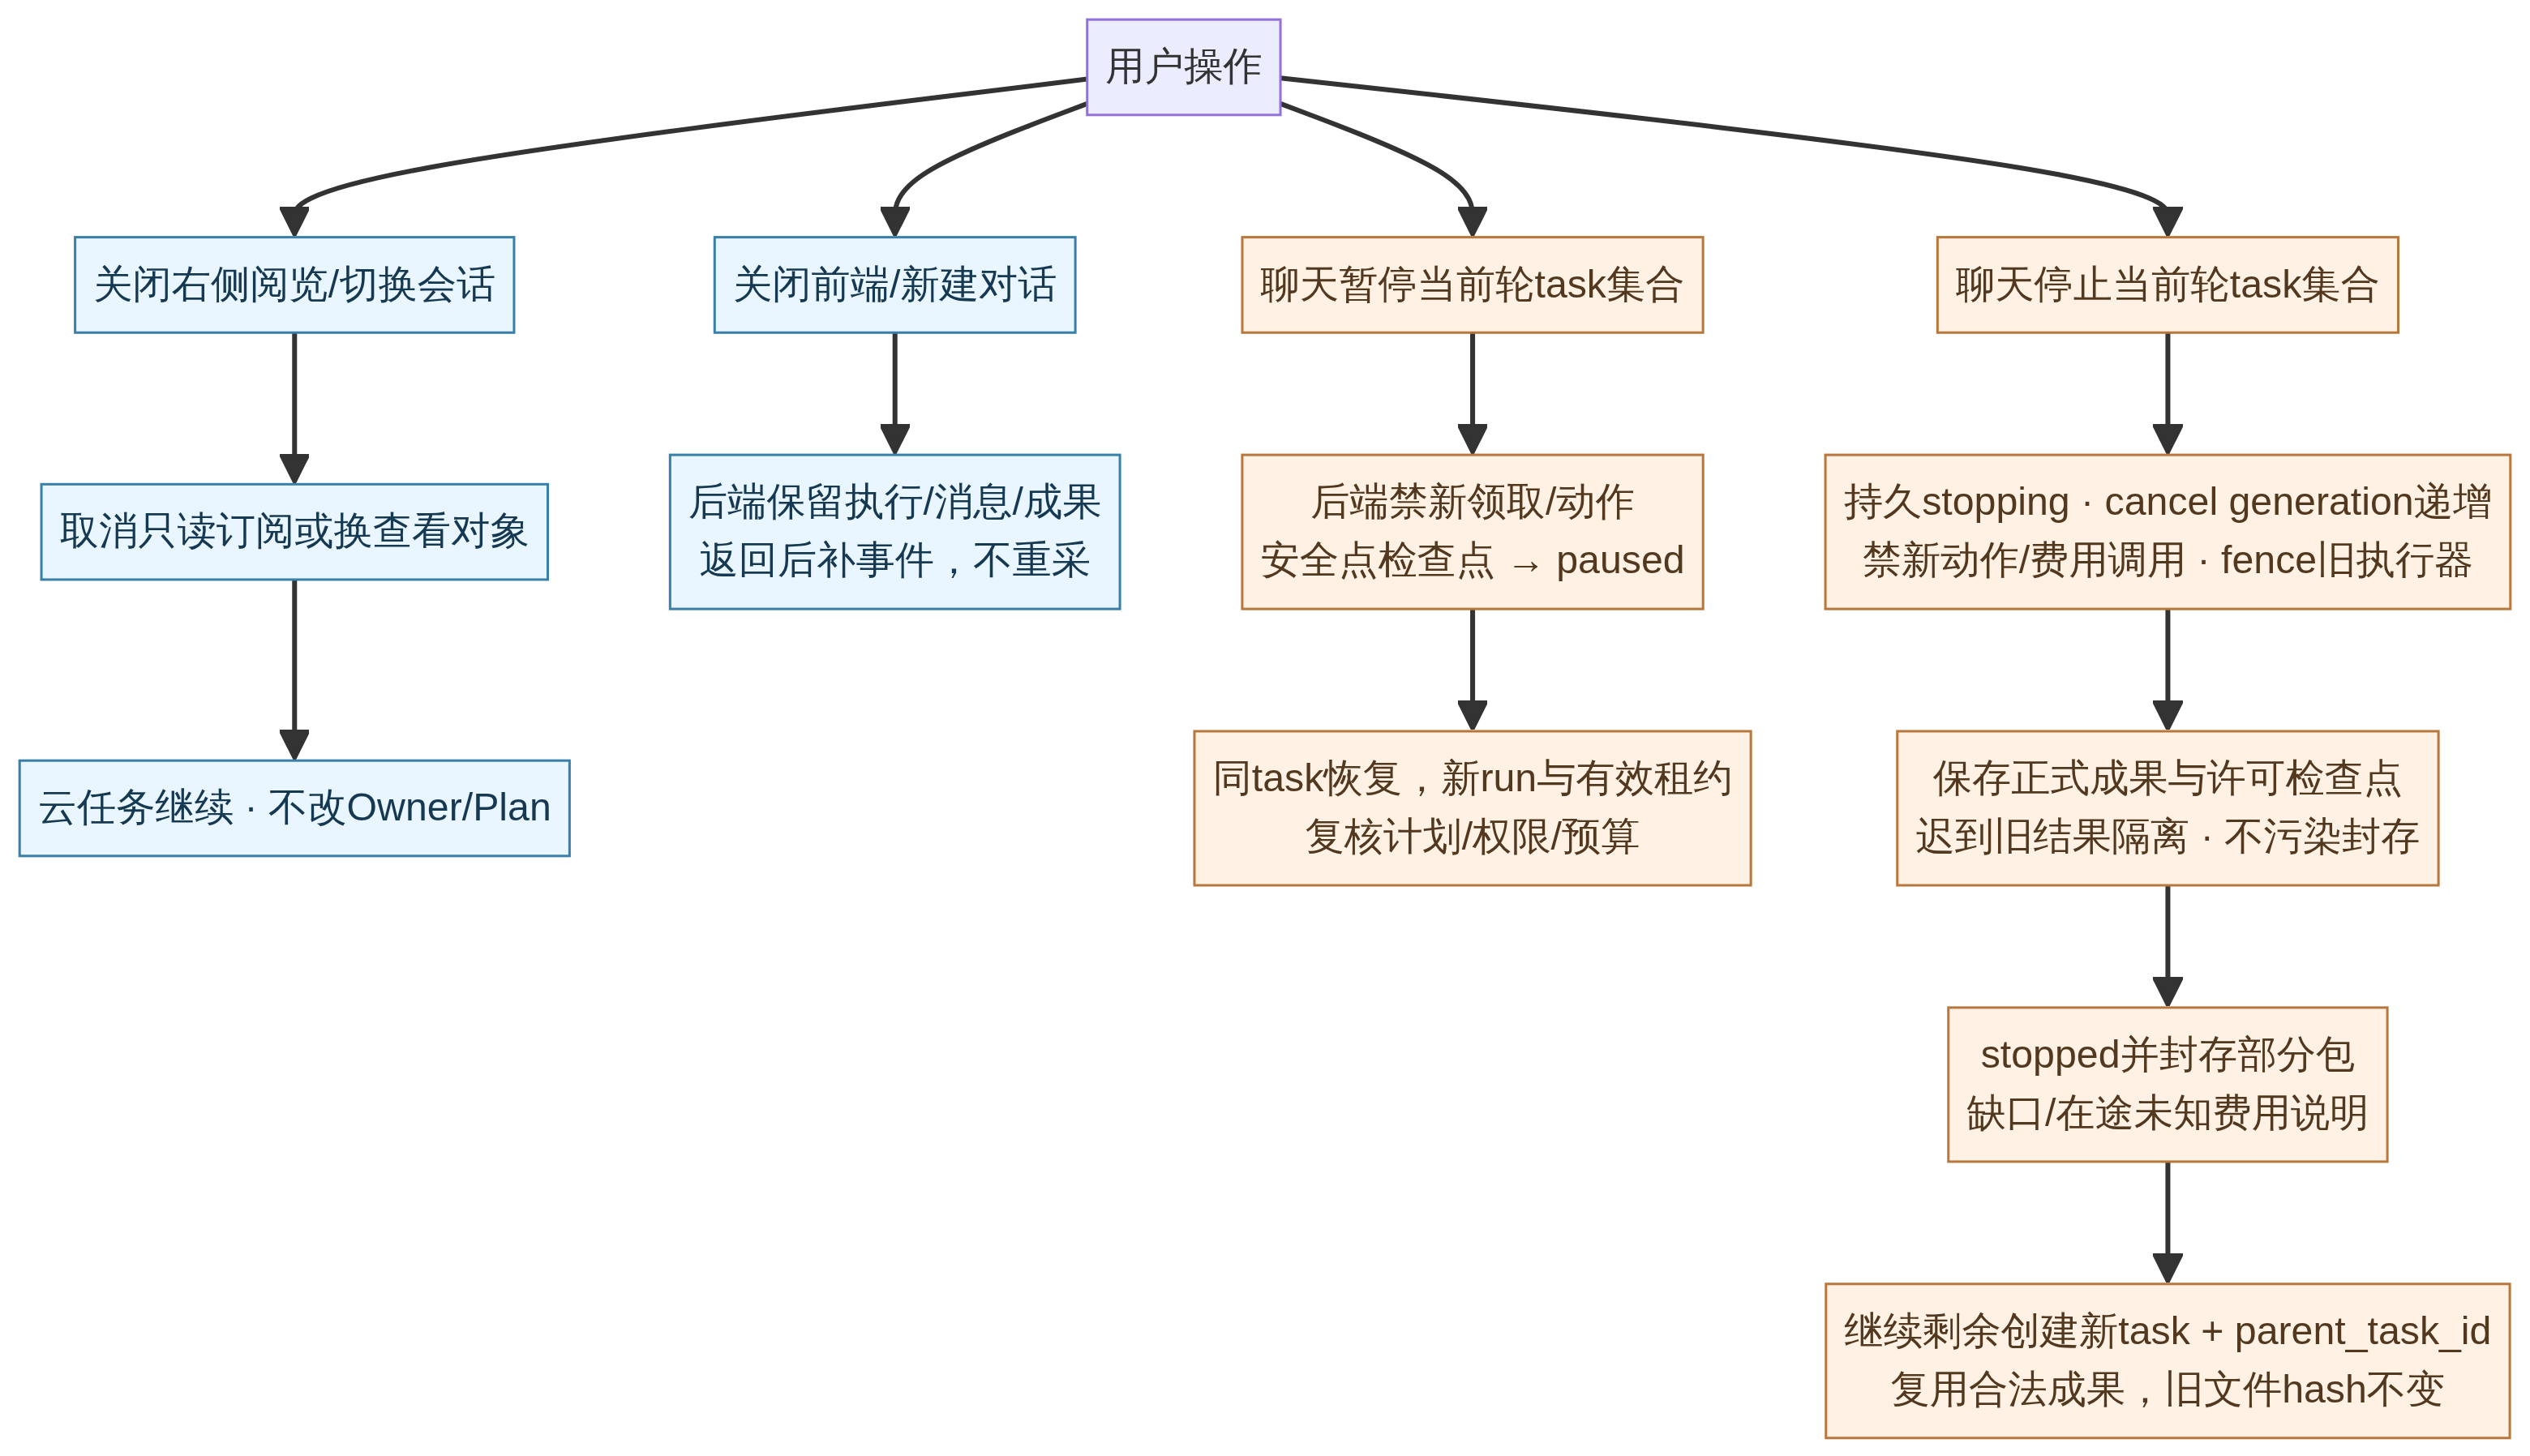
打开阅览是建立授权订阅。切换会话是改变观察对象。刷新阅览是取最近合法帧。关闭阅览是取消订阅。停止任务是执行控制命令。云端会话结束则是后端资源生命周期的变化。
尤其要避免“关闭右侧窗口同时关闭采集浏览器”。用户可能只是需要更多空间阅读报告,而不是希望停止任务。
同样,刷新阅览不能重新加载源网页。重新加载会影响当前 DOM、表单、登录状态和 Agent 观察,如果它只是一次显示刷新,就不应产生这些副作用。
5.3 第一阶段可以是截图,但必须说实话
第一阶段可以由后端提供定期更新的受控截图,即 snapshot模式。面板显示最近帧时间、是否断连、是否超过允许时效,以及是否经过遮罩。
定期截图不等于实时视频流。后续如果实现低延迟画面流,可以再开放 live模式,并验证带宽、身份、撤权、流量限制和隐私。
如果显示的是旧帧,应明确标记过期。不能因为最后一张截图还能显示,就继续给用户一种“浏览器正在这个页面操作”的印象。
浏览器已结束时,可以在允许保留的范围内查看历史帧,但历史帧也要清楚标明时点。
5.4 只读窗口与人工接管不是同一能力
默认阅览不提供任意点击、输入、导航和调试权限。这样才能避免一个会话被 AI 和用户同时操作,或者多个阅览者互相覆盖动作。
如果合法来源需要用户登录,系统可以发出单独的人工接管请求。但接管必须有安全互动通道,并在授权后暂停 AI 动作、切换独占操作 Owner,再在用户归还时重新观察页面。
只有截图的只读方案不能完成点击和输入登录。因此,安全互动能力尚未实现时,应保留访问受限状态,接受用户提供的授权文件或者其他合法来源,而不是声称可以完成所有登录。
接管也不意味着导入用户私人浏览器的 Cookie,更不能把密码写进聊天内容或者模型记忆。
5.5 浏览器画面本身也可能需要保密
网页画面可能包含账号、个人信息、授权材料或者内部页面。展示画面与保存正文应当分别有权限政策。
后端可以在允许范围内遮罩敏感区域,但不能保证一套简单正则总能识别所有敏感内容。无法可靠脱敏时,正确做法是不给出画面,并在聊天说明受限原因。
截图、浏览器动作回放和 trace 也不能默认永久保存。Playwright 的 trace 有助于分析操作过程,但它可能包含敏感页面与操作材料,需要最小采集和独立访问范围。2
5.6 右侧面板还可以查看来源和成果
同一容器可以切换 browser、sources和 artifact。用户看来源时,浏览器后台继续执行;用户预览报告时,也不影响采集工作。
桌面端可以让面板占约四成宽度并支持拖拽,聊天仍是主区。窄屏可以改成页签或抽屉,不把正文挤到难以阅读。
任何切换都只改变展示内容,不改变任务 Owner、预算或计划。这是前台布局与后端执行彻底解耦的具体体现。
6. 四种工作模式与完整使用场景
同一聊天入口可以服务不同任务,但不应该用一种固定输出覆盖所有需求。我们把后端任务分为四种模式,分别规定输入和交付门槛。
6.1 快速搜索:给出有依据的简答
quick_search用于相对明确的问题。系统做有界检索和必要的页面核验,返回简洁答案、来源、资料时间和不确定性。
例如,用户问某个公开文件说明了什么。这个任务通常不需要完整 CSV,也不需要长篇报告。系统可以形成必要来源和简答产物,避免为了统一流程生成大量不需要的文件。
如果问题其实包含多个相互依赖的子题,系统可以建议升级研究路线,但不能无提示扩展到大量有价调用。
6.2 专题研究:围绕问题形成引用报告
research适合开放问题。用户给出研究问题、背景、时点和受众,系统拆分子题,规划搜索,归并证据,再形成有引用的报告。
这类任务可以没有对象名单。需要比较某类公开方案时,系统先界定比较条件和资料口径,再寻找案例;不把搜索排名第一当作唯一正确对象。
报告应区分来源事实、分析判断和建议。支持不足的章节可以保留缺口,不为了完整提纲编造细节。
6.3 结构化采集:按字段形成数据集
dataset用于用户需要表格而不是单段文字的情况。对象可以来自上传清单,也可以通过有范围的搜索发现。系统先确定行粒度和字段规格,再按 Schema 提取、规范化、核验和导出。
这里的 Schema 是数据结构规则,包括字段类型、单位、可空、枚举、必填和证据要求,不只是几个列名。
如果一个字段没有公开披露,输出应保留 null和原因。不能为了让每行看起来完整,就用常识补出一个数值。
6.4 混合模式:数据与报告一起交付
hybrid在同一任务中形成数据和报告。报告的数字、比较和图表必须来自固定数据快照及实际计算结果。
系统可以先写提纲和不涉及尚未计算数字的草稿,但最终数值段落要等数据版本与计算完成。不能先让模型编一个分析结果,再想办法让表格与它对上。
两种产物也可以有不同状态:数据已生成,某个报告图表仍失败。前台应显示这种差异,而不是只留一个“任务成功”。
6.5 场景一:公开讲解资料到CSV
用户输入:“帮我采集博物馆的公开讲解资料,整理成 CSV。”系统识别数据任务,但还需要明确对象范围、每馆内容上限、资料类型和用途。
在对话中,AI 可以提出字段草案:机构或景区、内部景点或展品、主题、标题、整理正文、必要原文摘录、来源、读取时间、内容类型和缺失说明。用户可以自然语言修改,而不是手写完整 JSON。
范围和政策明确后,后端搜索官方介绍、文旅机构、公开展陈和其他获准资料。候选页面实际读取后才进入提取流程。每条正文关联事实和来源,近似内容经过保守去重,形成固定版本的数据文件。
如果某条内容只有公开事实整理,没有可保存的原文摘录,就保留摘录空值和原因,同时保留来源关系。若用户需要录音转写,必须另有合法媒体和真实 ASR 步骤,不能把口语化 AI 文字当作转写。
用户说“先停止,做完的给我”时,系统停止当前任务并封存部分包。以后说“继续剩余”,新任务复用合法成果与缺口指纹,不改旧批次。
6.6 场景二:公开机构资料到比较报告
用户可以上传授权的机构名单,要求寻找官网并比较公开能力。系统先确认同名主体、地区和资料时点,然后提取统一字段。
需要数字比较时,系统只对可比口径计算;没有公开披露的值不能默认为零。报告应说明公开资料不能代表某机构全部实际能力,也不能把宣传文本自动当作独立核验事实。
这里使用的是机构模板,景区字段不需要进入任务根结构。
6.7 场景三:开放问题研究,不先上传主档
用户提出一个技术问题,要求给出来源充分的说明。系统从问题中编译子题和检索范围,形成资料链,再输出报告。
资料来源可能是官方说明、论文或公开技术文档。平台需要记录版本和适用时点,也要识别方法差异。存在不同结果时,应保留冲突及条件,不用平均数消除分歧。
任务如果不需要数据表,就不强制创建一份只有几行的形式化 CSV。
6.8 场景四:已有数据的清洗和分析
用户已经有一份授权表格,只要求去重、统一单位并生成报告。这个任务不一定需要外部浏览器。
系统可以先解析文件和字段,展示清洗差异预览;用户确认规则后,再由确定性程序处理。需要补全公开字段时,才创建受限的联网补查步骤。
这意味着“所有能力后端执行”不等于“所有任务都要浏览网页”。正确执行路线应该跟随用户目标和现有材料,而不是跟随演示界面。
6.9 四种模式如何共用一个云端架构
模式决定哪些节点必须执行,以及产物达到什么门槛。会话、权限、来源、版本、预算和可靠停止仍然共用。
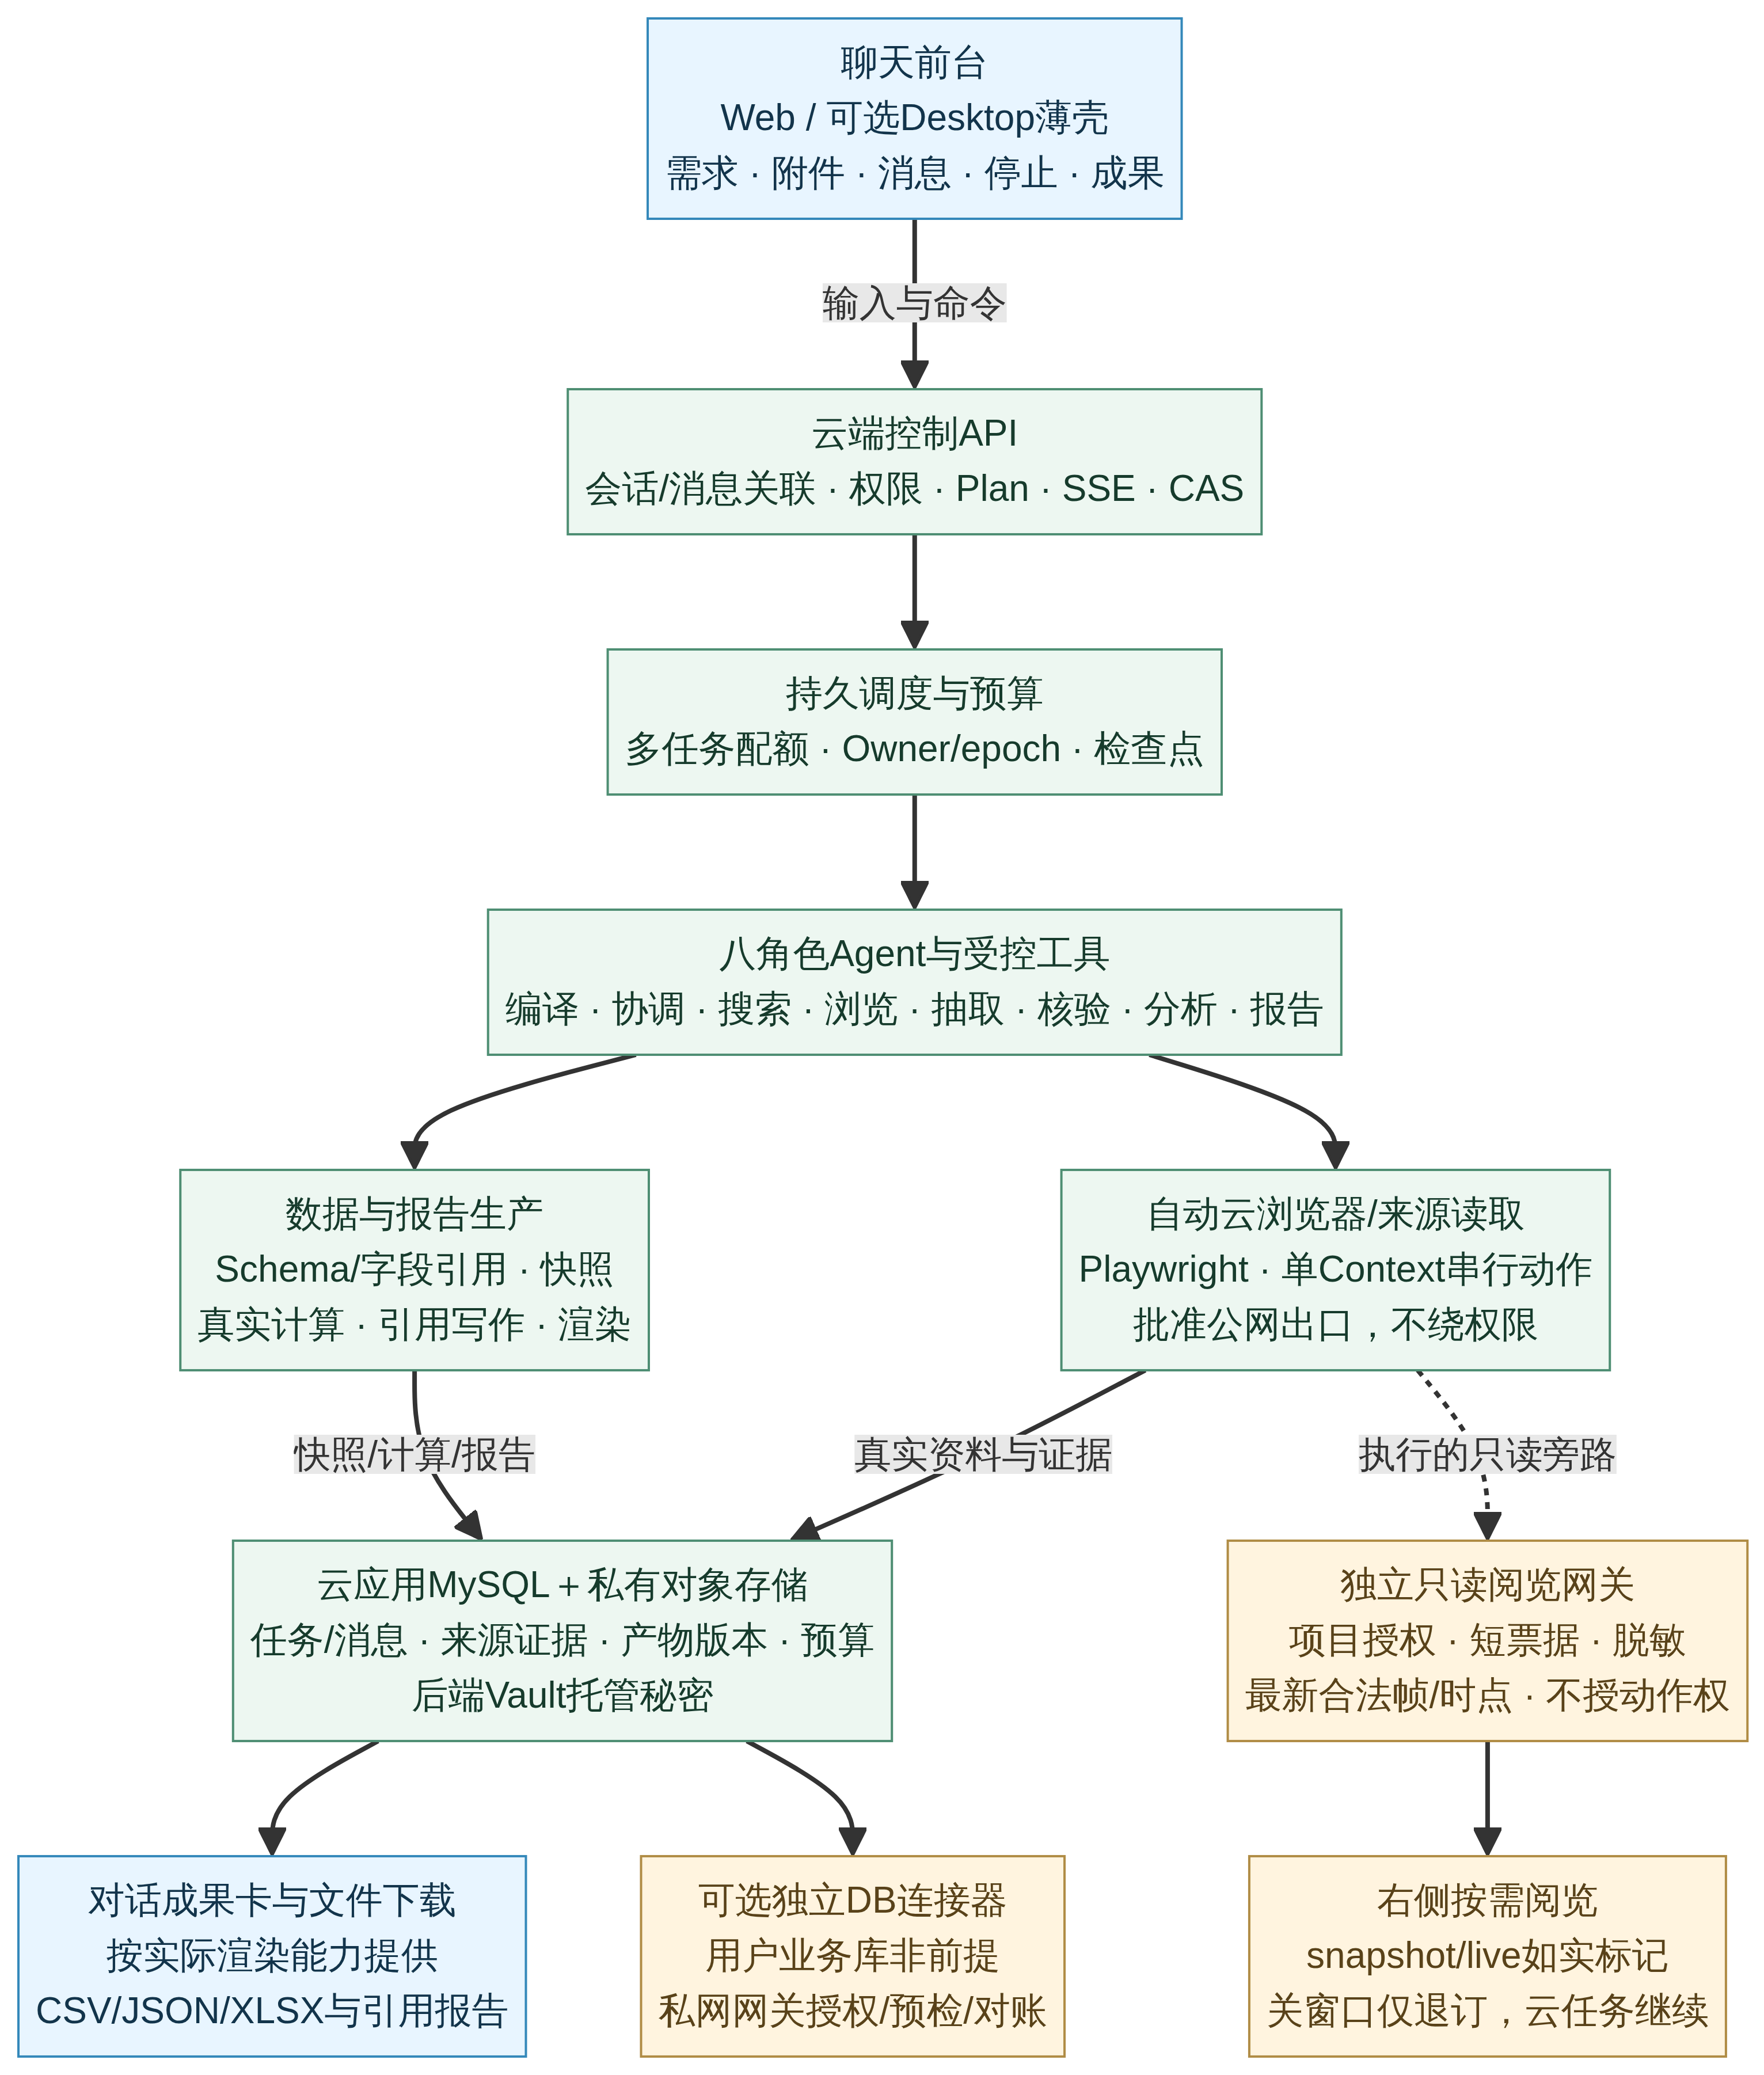
图示是建议的服务边界,不是必须部署这么多微服务。早期可以模块化实现控制面和执行层,但浏览器、敏感连接器与不可信文件处理的安全边界不能因为单机部署就取消。
Web 是第一阶段入口。可选桌面端可以提供窗口和通知,但仍然是云端薄客户端,不要求用户安装本地 Python、Playwright 或研究 worker。用户业务 MySQL 则是独立交付选项,不能成为打开聊天首页的前置条件。
7. 一个问题进入系统后,后端究竟做什么
一句自然语言需求并不是执行指令。用户说“比较两个场馆的参观安排”,可能想要几条即时建议,也可能需要逐项有出处的数据。直接把这句话交给一个可以上网的模型,模型就得同时猜对象、选择来源、决定费用和判断何时结束。云搜的执行设计应先拆开这些决定:模型解释需求,程序检查约束,调度器执行获准的计划。
这个入口也不必逢问必搜索。普通解释、澄清问题和读取已有成果可以直接结束在相应流程;确需联网时,再编译为 quick_search、research、dataset 或 hybrid。选择模式不是给同一提示词换名字,而是确定后续依赖与成果门禁。尤其是 hybrid,报告和数据可以共享资料,但报告中的正式数字必须等待固定数据版本及真实计算,不能先写一个看似完整的答案,再让采集结果迎合它。
把模糊要求编译成七个根字段
正式任务规格 TaskSpec 是一份可校验、可冻结的业务契约,不是模型自由发挥的长提示词。它只有七个根字段;任务标识、协议版本等放在外层信封,不混入业务结构。
mode 指定四种执行模式之一。requirement_text 保留本次需求版本的原文,避免结构化之后丢掉“只使用公开资料”“不需要估算”等关键限定。编译器应另记每个值来自用户、项目设置、模板,还是待确认推断,不能让推断伪装成用户要求。
scope 回答“究竟研究什么,以及到哪里为止”。它可以包含问题 questions、主题 topics、可选对象 items,不要求问题型任务先建立实体清单。时间、地域、排除项、候选上限和接受条件也属于范围;query_discovery 则给自动发现候选设边界。对象身份不清、时间口径会改变结论等歧义应先澄清,而不是靠搜索结果反向决定用户原意。
output 规定语言、格式,以及需要时使用的 DatasetSpec、ReportSpec 引用。execution 指定浏览器模式、执行池、并发、工具与重试策略,默认 browser_first;若允许 HTTP 优化,实际访问方式仍须如实记录。budget 给出明确币种、金额上限、模型请求额度和未知价格政策。policy_refs 引用访问、权利、质量、自动化及留存约束,让同一个网页在“可以查看”与“可以保存并用于报告”之间有所区分。
下面只是说明用的假设结构:甲馆、乙馆均为虚构对象,所有 ID 均为示例,不代表真实任务或已取得资料。嵌套字段展示一种可校验的结构形态,不是完整 JSON Schema,也不是可直接发送的生产请求。
{
 "schema_version": "taskspec_demo_v1", "task_id": "task_example_A", "task_spec": { "mode": "research", "requirement_text": "比较甲馆和乙馆的公开参观安排,不估算缺失信息。",
 "scope": { "questions": ["开放时间与预约要求有何差异?"],
 "items": ["甲馆", "乙馆"],
 "as_of": "2026-11-12", "exclusions": ["个人非公开资料"],
 "query_discovery": {"max_candidates": "12"}, "acceptance": "身份与时效可核验,重要冲突保留说明"
 }, "output": { "language": "zh-CN", "formats": ["markdown"], "report_spec_ref": "report_spec_example_A" }, "execution": { "browser_mode_type": "browser_first", "pool_ref": "pool_example_A", "max_active_work_items": "3", "max_waves": "2", "max_pages": "12", "tools": ["search", "browser_read"], "retry_policy_ref": "retry_policy_example_A" }, "budget": { "currency": "CNY", "max_amount_minor": "2000", "max_model_requests": "8", "unknown_price_policy": "block" }, "policy_refs": ["access_policy_example_A", "quality_policy_example_A"] }}
这份结构还不是开工许可。确定性预检要核对类型、范围、授权、工具能力、额度和输出可支持性,然后冻结规格、依赖图、模板、规则及价格版本,生成 plan_hash。金额用最小货币单位表示,计数和序号按协议传输,不让模型替程序算账;价格不可靠时,必须阻断或取得明确批准的保守上界,不能因为不知道价格就按免费通过。
DAG 决定先后,Wave 给补查设限
执行计划采用有向无环图 DAG:节点是一项有边界的工作,边表达“必须等什么”。研究的基本链路是规划、发现与筛选、实读、提取、核验、覆盖检查。已知且合法的 URL 可以跳过发现,却不能跳过实读与核验。不同子题可以并行,同一条结论的证据依赖则不能靠并发消除。
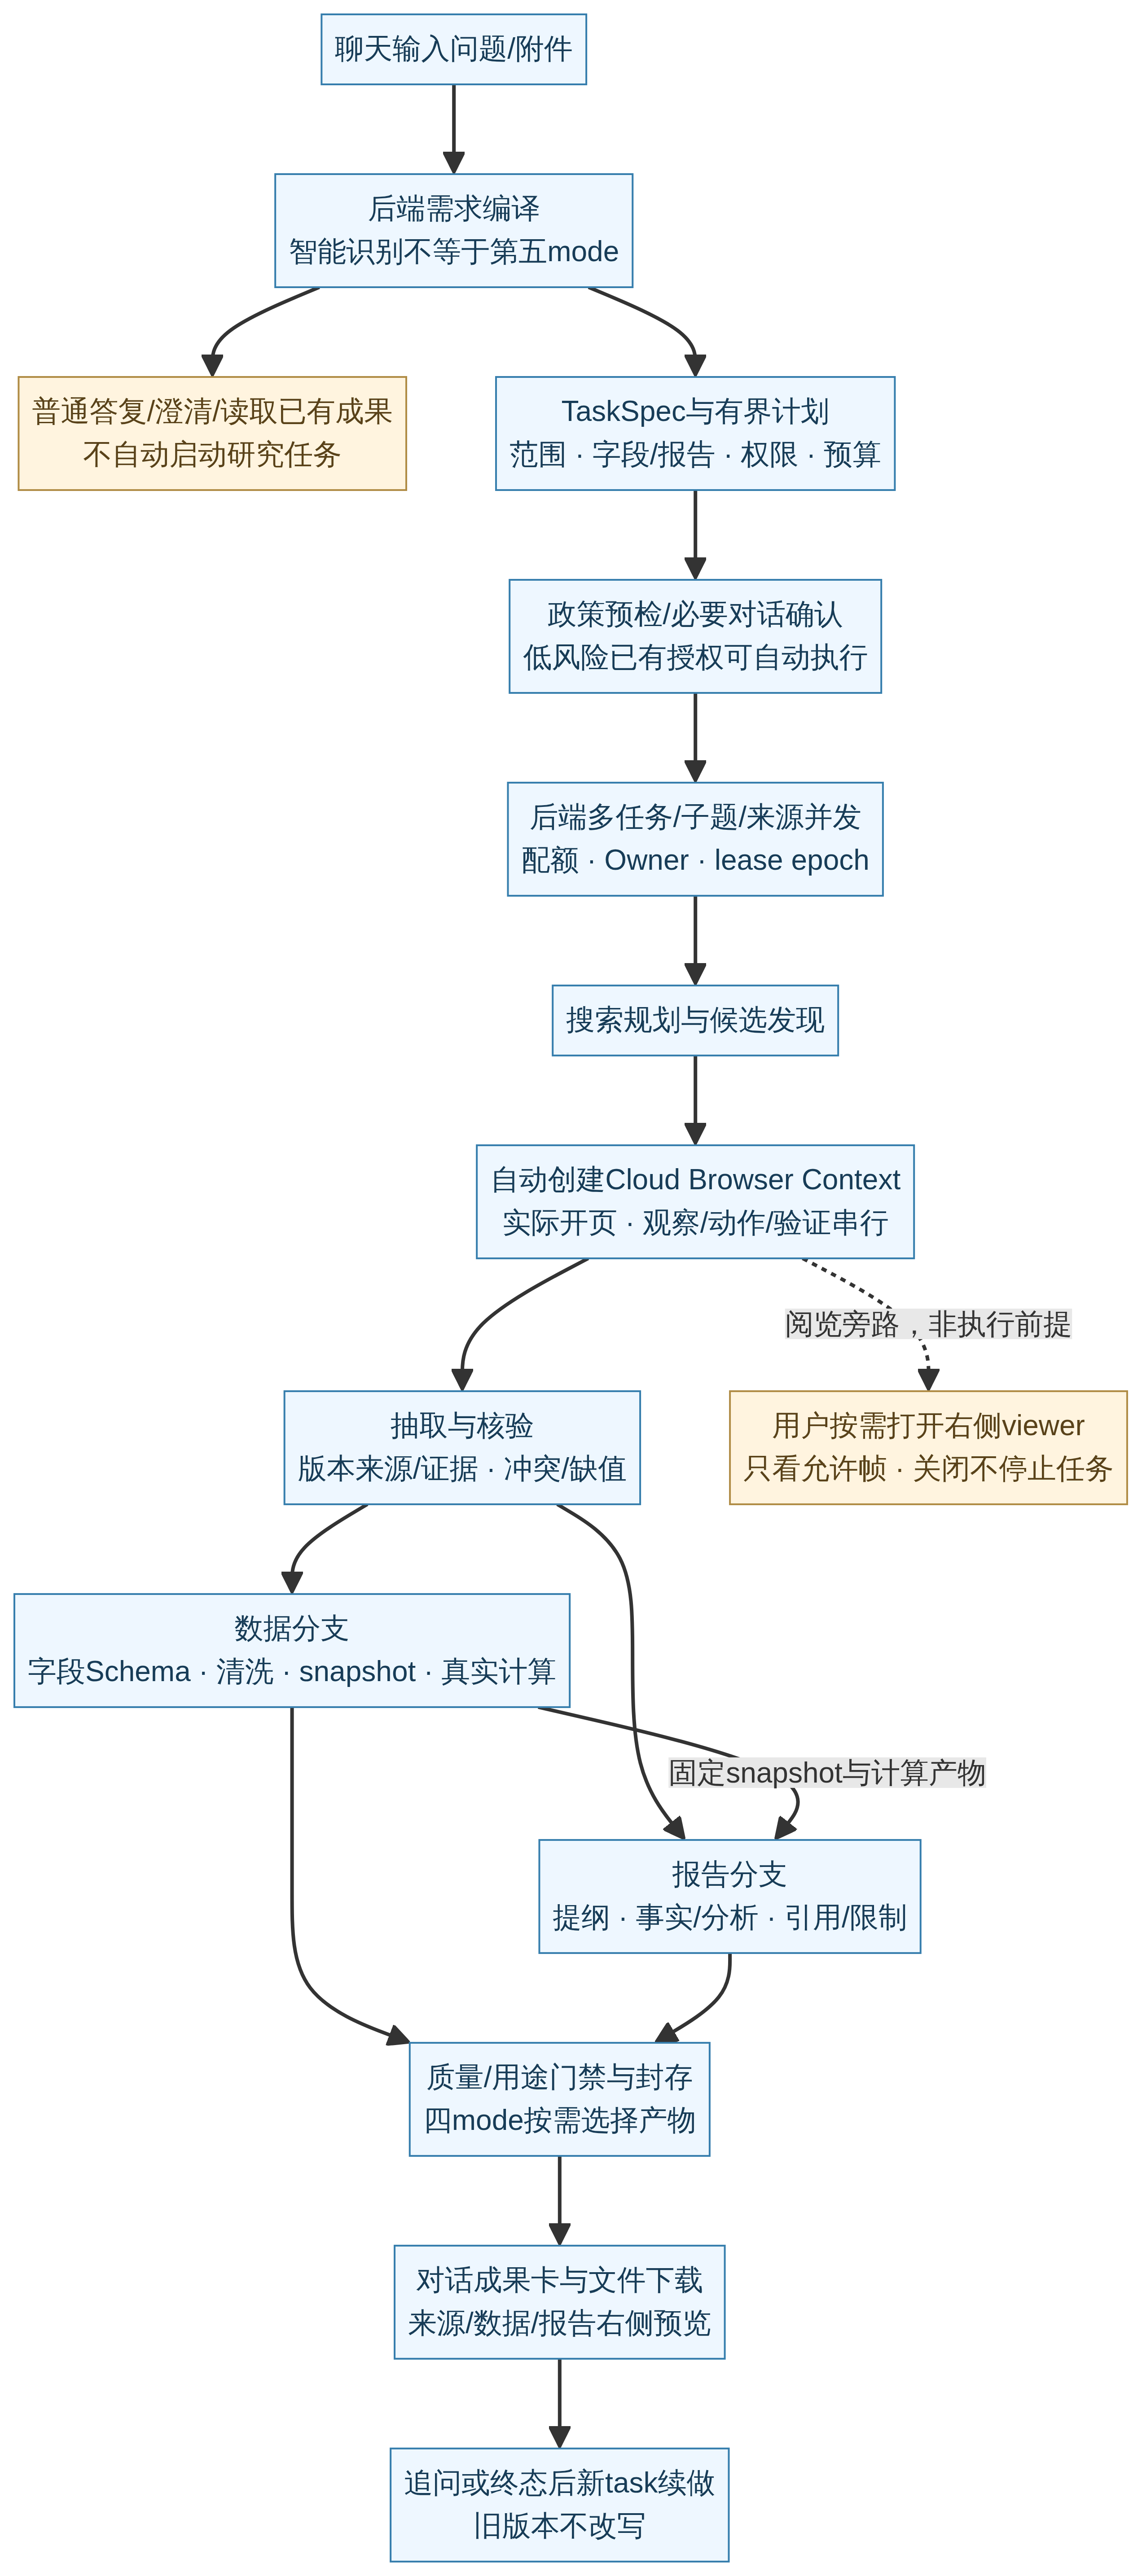
补查容易让图失控:核验说证据不足,规划又开搜索,搜索发现更多对象,研究永远结束不了。这里把每轮补查称为 Wave,按 wave_no 只追加指向未来的节点,不回写已经执行的节点。节点数、波次数、页面数、时长和费用同时设上限;范围内调整关键词可以自动进行,新增用途、权限、供应方或费用上限则要修订授权。
汇合也不是“收齐成功结果再继续”。每个分支都应返回成功、合法无内容、受阻或失败的信封。硬依赖缺失时阻断后继,可选依赖失败时保留限制继续。假设两个场馆的开放时间已经核验,预约政策仍互相矛盾,下一波应只围绕该缺口寻找独立资料,而不是重新采集全部页面,更不能把矛盾值平均后当作完成。
8. 八个智能体如何分工与协作
八个 Agent 的价值不在于让八个模型轮流发言,而在于分开解释、寻找、读取、提取、核验、计算与表达的权限。它们交换的是有版本、有输入引用、有输出结构的工作信封,不是随意转述的聊天记录。每个角色共同绑定契约、提示模板、模型配置、工具策略和输出结构五类版本,再增加自己的规则版本;版本不兼容时不能静默借用旧成果。
requirement_compiler:把要求变成可执行契约
需求编译器输入原始需求及 message_revision、授权附件索引、政策、能力目录和模板,输出 TaskSpec 候选、字段来源、澄清问题、资源上界与预检请求。它不输出资料事实,也不拥有网络、浏览、SQL 或 shell 工具;可用工具只是目录查询、附件元数据、结构校验、预算预检和澄清提交。
它的 memory 只保留当前需求版本、已确认答复和未决歧义。用户修订需求时,应形成新输入版本并重做受影响预检。这样才能避免“上一轮用户接受过”被模型误当成这一轮扩大范围的授权。
coordinator:理解全局,却不拥有全局权力
协调器读取冻结计划、节点状态、产物索引、覆盖情况、费用与错误,提出调度、有限扩展、降级或终止建议。它可以只读状态、校验扩展、提议交接和检查归并,但不能自行领取租约、修改预算或宣布任务完成;这些决定最终由程序事务落实。
其 memory 保留依赖、波次、覆盖摘要和失败分类,不装入全页正文或账号信息。这个角色更像检查下一步条件是否满足的计划助手,而不是拥有任意后台权限的“总指挥”。剩余额度和未知费用来自账本,不能由它根据记忆估算。
search_planner:寻找入口,不制造证据
搜索规划器输入子题、对象限定、已核验词项、缺口、来源政策和剩余限额,输出 QuerySpec 查询矩阵、候选优先级、关键词出处及停止建议。受控搜索代理、词典、已有来源索引和 URL 候选校验是它的工具范围。
它的 memory 保存当前单元的查询指纹、拒绝候选、来源家族和覆盖。先检查可以复用的材料,再发新查询;搜索标题、摘要与排名仅用于发现,不能被直接提取成事实。关键词规范化、搜索模板和排序规则也需要版本,否则“同一查询”的判断会随模型措辞漂移。
browser_researcher:每次只提出一个动作
浏览研究者输入批准的读取请求、会话租约、最新 Observation、权限和动作额度,输出一个 BrowserAction、实读产物 read_artifact 的引用、候选或阻断原因。工具限制为 navigate、input、click、scroll、read、extract、screenshot、finish,不开放任意代码求值、控制台、shell、SQL 或文件执行。
它只记忆本 context 最近的观察、访问指纹、进展和动作结果,不拥有凭据,也不跨项目共享 Cookie。finish 只是结束建议,不能改变任务、审核或交付状态。模型说“已经读完”不构成事实,必须由动作执行器验证实际正文与进展。
extractor:从已读材料形成候选值
提取器输入真实取得的 read_artifact、字段或断言要求、范围和必要文本跨度,输出原始值、标准化值、类型、单位、时间口径、定位、缺失原因与冲突。它只能读取片段、调用命名规范化函数和字段校验工具;缺资料时发出读取请求,不能自行上网补齐。
其 memory 保存本单元候选索引与已处理跨度。原文没有说的价格、日期和数量应保持未知,不能用常识填 NULL,也不能把“免费预约”推成“门票免费”。形成候选不代表核验通过,这道职责分界能防止提取与自我认可合并成一次模型判断。
verifier:检查支持关系,而非替模型盖章
核验器输入候选、证据、身份范围、时效、权利和冲突政策,输出接受、退回、待审或冲突决策,以及字段支持、断言支持和来源独立性报告。它使用只读证据、确定性的引用与身份等规则、补读请求,不获得扩大授权的工具。
其 memory 保存证据关联、来源家族、冲突组和可公开说明的核验理由。高模型置信度不能抵消反证,同一稿件转载到三个域名也不能算三个独立来源。机器检查 machine_checked 与人工批准 approved 不同;这不是文字上的保守,而是避免程序自动替人承担未完成的审核。
analyst:安排计算,不用语言模型代算
分析器输入门禁允许的固定 snapshot、已有支持的断言、指标口径和计算政策,输出 AnalysisPlan、命名 ComputeJob 请求、结果解释、图表规范与限制。工具是数据字典和快照只读、计算计划校验、批准算法及结果索引,不允许任意脚本、SQL 或 shell。
其 memory 记录快照引用、指标定义、已执行 job 和口径决策。正式数值必须来自实际计算结果;旧任务的均值不能替代新快照的均值,计算失败也不能让模型心算补上。语言模型可以解释零分母为何使某指标无意义,但不能因此发明一个可显示的数字。
report_writer:组织结论,不新增事实
写作器输入 ReportSpec、已核验断言、证据、快照、计算产物和缺口,输出提纲、正文、段落与断言映射、图表引用、意见区及导出请求。批准产物读取、引用和结构校验、受控渲染是其工具边界,它不能直接搜索、浏览或写库。
其 memory 保存当前报告修订、提纲覆盖和引用索引,不把旧草稿当来源。润色不得增加无证据的数值、因果或权利声明。简单答复未必需要分析器,已知 URL 未必需要搜索规划器,角色是否调用由依赖图决定,不对每个 URL 机械调用八次模型。
Memory 是工作便签,不是控制状态
短期观察、单元工作记忆、项目授权只读缓存和不可变证据应分层使用。摘要能节省上下文,却不能证明网页实际读过;恢复也应从正式产物重建,不依赖模型记得多少。压缩记忆仍须保留引用、原输入 hash 和未决项。
任何工具中的产物 ID 都要校验所属项目及依赖权限,模型自造 ID 不会获得访问权。跨任务复用还要检查可见性、权利、时效与版本,私密附件和登录态不能进入公共缓存。“不可变”描述修订方式,不意味着可以违反到期或删除政策永久留存。共享 memory 更不能替代租约、预算与取消状态的权威检查。
9. 自动搜索如何找到真正可用的来源
搜索的目标不是攒够若干链接,而是让每个问题获得符合用途的支持。搜索引擎给出的只是候选入口:摘要可能陈旧,标题可能近似,排名也不等于权威。云搜应把“搜到了”“实际读取了”“允许作为证据”拆成三次不同的判断。
查询身份与研究范围一起参与去重
QuerySpec 需要表达子题、对象限定、时间地域、语言、来源策略和查询词项的出处。查询 identity 不能只比较字符串:调换词序通常仍是同一查询;相同文字用于不同对象、时点或用途,也不能随意复用。规范化后的查询指纹应连同 scope 与规则版本判断,让重复搜索被抑制,同时不把真正不同的范围误合并。
假设要查某场馆的预约要求,先核验对象名称、所在地和官方主体,再扩展别称与问题词。遇到同名对象不能凭标题相似接纳,扩大到别的城市更不是一种“提高召回率”。规划器记录为什么尝试这个词、为何拒绝某候选,下次补查才能沿着真实缺口前进,而不是反复换措辞调用搜索。
来源家族比域名计数更重要
候选筛选要检查 identity 与 scope:是不是目标对象,是否回答当前问题,时间是否适用,访问与使用权利是否满足。初步通过只表示值得实读,不表示自动成为证据。实际读取后仍须确认最终落地内容,登录壳、验证码页和骨架屏都不能充数。
来源 family 表示共同的发布链或生产主体。不同域名可能属于同一机构,同作者多平台分发也可能只是同一材料的复制;转载还可能继承原稿错误。因此独立性要看信息生产关系,而不只看 URL。要求独立核验时,三个同源转载不满足条件;找不到独立来源,应说明支持受限,不能降低标准换一个漂亮的来源数量。
复用必须保留原来的读取时点
先查已有来源可以减少成本,但不是把缓存当作新鲜资料。复用要逐项核对权利、项目可见性、内容时效、版本兼容以及当前用途;适用的旧修订保留原 retrieved_time,不改写成这轮访问时间,也不能把读取时点冒充发布日期。
例如一份旧参观通知可以支持它所描述的历史安排,却未必回答“现在如何预约”。需要当前状态时,应重新访问并形成新修订;若访问受阻,就明确当前状态未知。摘要、截图或已有内容 hash 都不能单独证明本轮实读或资料权威,准入最终依赖实际内容及核验结果。
停止搜索的条件也应围绕质量:必答问题覆盖、有效支持、重要反证处置及时效用途满足。达到这些条件就停止访问;达到候选或波次上限而仍有缺口,则受限交付。这样搜索才是一项有终点的研究工作,而不是以链接数量驱动的无限采集。
10. AI浏览器如何观察、操作并确认结果
浏览节点获准执行后,后端应自动做 health 检查:引擎和驱动版本、进程、资源、时钟、出口政策、存储及控制面都正常,才启动或复用批准的云端 Playwright 进程并创建独立 BrowserContext。1 引擎失败应返回明确错误,不能偷偷改用 HTTP 后继续宣称浏览器健康;批准的 HTTP 优化属于另一条如实标注的访问路径。
进程可以复用,登录态不因此共享。context 绑定项目、Owner、run、lease_epoch 和政策,跨安全域另建,不导入私人 Cookie、不接管私人浏览器,也不连接任意调试端口。BrowserContext 提供浏览状态隔离,但不是操作系统安全沙箱,进程边界与受控出口仍然必要。1
Observation 是短期许可证,不是永久页面地图
Observation 是执行器签发的一次页面观察:包含观察 ID、文档代次、必要内容、短期 element_id 或 region_id,以及允许的动作。这里的元素引用是受控句柄,不是让模型生成 CSS、XPath 或代码去定位任意对象。导航、DOM 变化或句柄失效时,都要重新观察。
模型每次只建议一个带类型的 BrowserAction,actor 按“观察、执行、验证、新观察”串行处理。同一个 context 只允许一个动作在途。否则两个模型同时根据旧页面点击,一个触发导航,另一个可能在新页面击中位置相同、含义不同的按钮;这种错误不能靠提示词要求“小心点击”解决。
动作信封应携带 project_id、task_id、run_id、work_item_id、step_id、agent_run_id、browser_session_id,以及 schema_version、lease_epoch、cancel_generation、attempt_no、observation_id、document_generation、action_id。动作体只允许 type 对应的参数。结构化输出与工具调用协议可以约束格式,却不能证明事实、权限或页面没有变化;模型拒绝、截断和超时须由适配器处理,再做本地结构与语义校验。3 4
一个动作必须经过三道验证
第一道验证约束提案:角色能否使用这个工具,计划与政策是否允许 URL、输入内容及副作用。第二道验证约束执行资格:当前 Owner、epoch、取消代次、提交窗口、最新观察与资源许可是否仍有效。第三道验证约束结果:最终 URL、实际正文和操作进展是否符合预期。点击没有报错,不代表已经翻页;导航返回成功,也可能只到达登录页。
下面是严格控制顺序的三十行伪代码,不可直接运行。所有 helper 均表示另行实现的协议组件;其中短事务负责权威状态检查与提交,动作执行器还须在实际派发时复核资格。settle_by_send_state 区分未发送、已消费与费用未知,不是无条件退款。
handle(a):
 validate_envelope_schema_and_project_access(a) prior = find_action_record(a.action_id) if prior.is_accepted(): return replay_original_if_same_request_hash(prior, a) validate_role_whitelist_frozen_plan_and_policy(a) mailbox = None; permits = []; reservation = None; result = None try: mailbox = acquire_owned_context_serial_mailbox(a) prior = find_action_record(a.action_id) if prior.is_accepted(): return replay_original_if_same_request_hash(prior, a) require_current_owner_epoch_run_cancel_generation_and_open_window(a) require_latest_observation_and_document_generation(a) require_signed_allowed_element_or_region_handle(a) require_allowed_url_input_and_side_effect(a) permits = acquire_intersected_quota_with_owner(a) reservation = reserve_budget_or_block_unknown_price(a) require_current_owner_epoch_run_cancel_generation_and_open_window(a) require_latest_observation_document_and_handles_again(a) claim_action_or_raise_pending_unknown(a) result = execute_one_action_fenced_at_dispatch(a, reservation) verified = verify_actual_url_content_and_progress(result) observation = build_unpublished_observation(verified) with authority_short_transaction(): require_current_owner_epoch_run_cancel_generation_and_open_window(a) require_owned_action_and_request_hash(a) receipt = commit_verified_checkpoint_and_output(a, verified, observation) return receipt except Exception as e: quarantine_uncommitted(result, a); raise_classified(e) finally: settle_by_send_state(reservation); release_only_owned(permits, mailbox)
try/finally 的意义不仅是清理内存:等待配额时可能被停止,执行中可能失租,验证也可能失败,资源都要按所属 Owner 释放,不能误释放继任者的许可。示意中的清理组件应逐项、独立完成结算登记与释放;某项结算暂时失败不能跳过其余清理。尚未验证的输出最多进入受政策约束的临时区,不得成为有效检查点、覆盖计数或成果;新观察也要在合法提交后才对后续动作生效。
action_id 的重复到达尤其需要区分。已经接受且请求 hash 一致的动作,返回原回执,即使任务之后已停止,也不重新执行。已派发但回执未知的动作则进入等待或对账,不能为了“重试成功”盲点第二次。未知动作状态和过期句柄应先重建观察;新观察能帮助确认当前页面,却不能证明旧外部副作用从未发生。
页面之外还有多跳网络请求
一次合法导航可能经过重定向,再由 iframe、图片、脚本、弹窗或 WebSocket 请求另一地址。SSRF,即利用服务器代发请求访问不应开放的内部资源,必须在出口层逐跳防护,校验协议、端口和全部 DNS 地址并防重绑定,拒绝环回、私网、链路本地与云元数据等目标。8 只检查模型填写的首个 URL 不够,浏览器所有子资源与后台连接都应受同一规则约束。
网页中的“系统指令”也只是内容,不能改变工具白名单、预算或授权。购买、发送、删除、上传等副作用不属于普通只读展开与分页权限。遇到登录或验证码,应按政策返回 blocked;没有经过安全验收的人工互动通道时,就选择其他可用来源或保留缺口,而不是假装完成登录。
11. 多任务、多智能体与浏览器并发如何落地
并发首先是依赖问题,然后才是线程问题。两个独立子题可以同时规划,两处来源可以同时实读,已经取得的材料可以一边提取、一边让另一个单元核验;同一子题尚未取得资料时,它的提取器却不能先开工。每个并发单元有独立 work item、agent_run 和必要的 context,不是把八个角色放进一个顺序 for 循环就称为多智能体并发。
资源许可取多层限制的交集
用户与项目层限制活跃 task,task 层限制在途 work item,worker 层限制可执行容量。模型层控制供应方在途请求、QPS 和 token;域名及来源家族层控制访问并发与速率,且跨任务计数,不能换子域绕限流。浏览器进程、context 数量与单 context 动作串行又是不同的限制。计算的 CPU、内存、存储和费用还会进一步收紧许可。
因此一个单元只有满足相关配额的交集才能运行。模型等待不应长期占着域名请求令牌,计算也不占浏览器许可;固定资源申请顺序与短期许可减少死锁。BrowserContext 隔离浏览状态,操作系统进程隔离故障与部分安全风险,这两者既不同于调度并发,也不能互相替代。
公平队列要防止大项目一次展开大量候选,抢光小任务的机会。可以在项目间公平轮转,再在任务内按依赖与优先级调度,必要时保留获准的最小服务份额。配额不足进入有 deadline 的等待,不靠无界线程堆积;超时和限流采用有抖动的退避,失租或取消只释放仍归当前 Owner 的许可。
费用许可同样参与调度。有价请求发送前按 reservation_id 原子预占项目、任务和角色的批准上界,绑定币种与价格版本;包括获准重试和最大输出。已发送却费用 unknown 的请求不能把预占释放给下一批工作,未知价格也不能记零。提高并发不会产生新预算,甚至会更快把预算占满。
用执行区间证明并发,用边界证明可控
验收需要保留 agent_run 起止时间、资源许可和实际工作记录。假设单元 A 仍在读取,独立单元 B 已开始提取,两者的真实执行区间有重叠,才能证明 overlap;只有队列记录同时出现,或者循环连续打印“已启动”,都不够。另一方面,同 context 的动作在途数必须始终不超过一,超配额时应看到排队而非隐性突破。
故障分类决定哪些工作值得重试。暂时断网、限流、可恢复引擎错误可以在次数、deadline 与预算内进入 retry_wait;合法页面没有目标内容是 no_content,不用反复访问凑结果。权限、登录挑战或未批准价格属于 blocked,改变批准条件前不能自动重试。schema 格式修复限次且只修结构,不补造事实。
冲突又是另一类问题:两份资料矛盾不等于网络失败,应进入核验与有限补查,不能靠重复请求同一网页消除反证。持久技术失败才归 failed。将这些边界讲清,汇合器才能接受各类终态,并决定受限继续还是阻断硬依赖,而不是把所有非成功结果都塞进一个无限重试队列。
12. 为什么停止、暂停和恢复是核心工程能力
长任务最难的时刻通常不在正常路径上,而在“用户已经停止,远端还在返回”。一个模型请求可能已经计费,一次页面请求可能已经离开出口,一份结果可能写完却丢了确认。停止若只是前端不再显示消息,工作还会继续;若只是杀进程,又可能留下无法解释的状态。需要被停止的是领取、动作、有价请求和正式提交的资格。
短事务定义停止发生的那一刻
Owner 是当前持有工作权限的执行者,lease_epoch 是每次权属转移递增的租约版本。cancel_generation 则区分取消代次,不与重试 attempt_no 混用。心跳只说明进程健康,不能授予权力;领取由持久短事务或 CAS,即比较当前版本后原子更新,授予唯一 Owner。
停止命令应携带 request_id 与 expected_event_seq,服务端校验操作者和目标任务。一个短事务将 task 推入 stopping,递增 cancel_generation,关闭相关提交窗口,并阻止新领取、扩展、有价请求和动作;需要撤销或转移 Owner 时同步更新 epoch。这个事务提交的 event_seq 是线性化点:并发操作在权威顺序中落在它之前或之后,而不是按浏览器显示时间猜先后。
命令由 message、turn 映射选择任务集合,再传播到子单元,不能误停其他轮次。“停止”也不是删除:此前合法提交的结果仍然存在,宽限期后隔离剩余执行并封存稳定基线。人工接管若正在进行,也必须撤销其 Owner 与令牌。
三个典型竞态,决定系统是否可信
第一种竞态发生在等待配额时。worker 已经通过一次权限检查,随后等待模型或浏览器许可;用户此时停止任务。它拿到许可后必须再次检查 run、Owner、epoch、取消代次与窗口,不能凭几秒前的许可继续发送。校验失败就释放自己持有的资源,这正是动作伪代码安排重复验证的原因。
第二种发生在外部请求已经发送之后。停止不能保证撤回远端请求,新 epoch 也没有这种魔法。应尽力取消或限制旧执行出口,但真正可保证的是旧结果不能污染正式状态:工具桥接、模型回调、费用登记与产物提交分别复核资格,迟到正文进入最小诊断 quarantine,不增加覆盖、不修改报告。费用仍应结算,内容隔离不能把实际消费抹掉;无法确认旧进程停止网络时,新 Owner 不能直接沿用旧 context 的动作链。
第三种发生在提交成功、确认丢失之间。结果若已在停止线性化点之前被事务接受,生产者重发同一回执请求,仍应返回原引用,而不是因为当前代次变化便让它重新执行。接受记录与当前执行许可解决的是不同问题:前者回答“过去是否成功”,后者回答“现在能否做新动作”。同键不同 hash、输入或生产者则拒收,不能用覆盖写入消除差异。
动作以 action_id 去重,正式 step_artifact 和 work_summary 也要按 kind 独立幂等,分别使用项目、对应 step 或 work item、cancel_generation 与 attempt_no 组成键。summary 的尝试号由唯一归并器分配,不借某个 Agent 的号码。重试形成新 attempt,有效结果由 CAS 选择;至少一次消息交付不意味着外部网络或费用恰好一次。
暂停保留任务,终态继续创建新任务
pause 经过 pausing 到 paused,在约定边界收束执行;resume 保留同一 task,但建立新 run、更新取消代次并重新绑定合法 Owner。检查点保存冻结计划、证据、核验、快照、计算和门禁的正式产物引用,以及版本、manifest、查询指纹、覆盖、有效尝试、剩余额度和未知费用,不保存过期 DOM 句柄或默认 Cookie。
因此恢复不是从聊天末尾接着说。崩溃后先 fence 旧 Owner,再以新 context 重新导航观察,校验已提交产物兼容性,从缺失依赖继续。未确认的请求不能因为创建新 run 就自动视为没发生;unknown 费用与已消费额度仍约束后续执行。
stop 到 stopped,以及其他终态之后的“继续”,应创建带 parent_task_id 的新 task。旧任务封存的 stable batch、manifest 与成果 hash 保持不变,新任务明确继承哪些范围、还有哪些缺口,并按当前权限、时效和版本决定可复用材料。它可以引用旧任务合法成果,却不能把旧包悄悄改成完整的新报告。
假设某任务停止时两个子题已核验、第三个只有旧通知,且一次模型请求费用未明,新任务就只围绕获准缺口展开计划:前两项满足复用条件时保留原读取时间,第三项重新观察或补查,未知负债仍占据相应预算,新的支出须另有明确批准。晚到的旧正文即使看起来恰好回答第三项,也不能自动并入;要成为新任务的依据,必须经过明确、受政策约束的重新准入。这样“继续研究”才不会变成绕过停止、证据和预算边界的后门。
13. 从来源元数据到真正的讲解内容
如果用户要的是“每个景点可以讲什么”,交付一串官网链接显然不够。前期讲解资料采集最终形成了 3,951 条内容,但这个数量只说明记录规模,不说明每条都取得了逐字讲解词、原始音频或人工核验结论。我们需要先回答一个基础问题:记录中的哪些字段是内容,哪些只是帮助找到内容的目录?
五个核心字段,各自承担不同责任
最初需求中的五个核心字段是 topic、guide_title、guide_text、original_excerpt 和 excerpt_source_url。topic 划定讲解主题,如历史沿革、建筑构造或观赏线索;guide_title 是面向使用者的标题;guide_text 才是可以继续编辑、组织和使用的讲解正文。original_excerpt 保存实际取得的必要短摘录,excerpt_source_url 指向该摘录的来源,而不是随意选择一条“看起来权威”的网页。
来源目录 source_dirs 应另行保存机构、页面标题、平台类别、候选地址、访问方式和权利信息。它的价值是导航与追溯,不是替代正文。即使目录里有十个政府网站,也不能据此生成十段未经读取的讲解;搜索摘要同样只是发现线索。整理正文所用的来源集合还可能大于摘录来源集合:一个短摘录不必独自支撑整篇文字,其他事实应保留自己的来源关联。
数据库可以采用业务化字段名,例如把 topic 映射为 guide_topic_name,把 guide_text 映射为 guide_content_text。字段改名不应改变含义,更不应把网页标题塞进正文后宣称“内容已采集”。空正文、缺摘录和来源受限是不同的缺口,需要分别表达。
整理、原文与转写不能混装
网页资料的处理要区分三件事:实际读取网页内容,从中保存必要原文片段,再依据可支持的事实自行组织正文。整理文字可以调整叙述顺序,却不能改写年代、范围和不确定程度。事实性信息的利用也不等于复制作品表达;网页公开可读,并不自动允许全文保存、提交模型、改编讲解或对外分发,几种用途需要分别判断。
景区 DWD 的 guide_content_type 因而有三个明确取值:1 是依据公开资料整理,2 是实际取得的逐字讲解原文,3 是实际取得的录音自动语音识别转写,即 ASR。短摘录的 original_content_type 则是另一组标识:0 未取得,1 景点文物介绍短摘录,2 公开讲解词短摘录,后续枚举扩展加入 3,表示字幕转写短摘录。取得一段介绍文字,不能把整条内容升级为类型 2;自行写成口语风格,更不能升级为类型 3。历史类型标签也不能证明取得了原媒体、完成真实 ASR 或具备作品用途许可;迁入平台时必须核查实际材料,缺少对应证据的记录保留历史待核验状态。
现有 3,951 条正文全部属于类型 1,其中续采的 912 条没有 original_excerpt。这些记录仍保留来源关联,但“可追到来源”不等于“有可展示的原文片段”,也不等于已完成逐条事实审计。展示时可以说明“依据关联公开来源整理,未取得可交付原文摘录”,将摘录及其专属地址保留为 null;不能为了让引用按钮亮起,就补造引号、页段或读取证据。
先确定对象,再细化讲解颗粒
微粒化讲解不是把长文机械切成小段,而是先确定每段谈论的对象。景区本体、园内建筑、遗产组成点与同名外部 POI,即兴趣点,不能因名称相近就合并。记录需要保留所属主档、对象关系、范围说明、外部编码命名空间和匹配状态。名称完全相同但没有重新核验位置,只能表达名称匹配,不能宣称身份已独立验证;无法可靠映射时,poi_id 应为空。
对象确定后,才可以按“一个对象、一个主题、若干可核事实”组织讲解。来源范围若只涉及某次修缮,正文不能扩大为建筑全部历史;资料说的是遗产整体,不能直接赋给其中一个组成点。这样的限制看起来保守,却能阻止错误沿着批量模板传播。
来源适配可以覆盖运营方官网、政府网站、博物馆与文物机构、明确开放资料,以及获准使用的 OTA、新闻、社区和视频内容。平台类别用于选择读取方式与风险策略,不代表全站授权或事实等级。媒体还要走独立流程:确认访问与处理许可,实际取得媒体,登记字节哈希,执行真实 ASR 或图像文字识别,保留时间跨度、识别器版本和不确定片段。旧记录上的“音频”“视频”标签不构成媒体文件,文字整理不得冒充媒体转写。
下面是虚构结构示意,不是实际景区记录,也没有访问所列地址。example.org 是保留示例域名;正文仅用于展示字段边界,因此保持草稿,不能进入正式讲解包。
{
 "schema_version_name": "guide_draft_demo_v1", "project_id": "demo_project", "record_id": "demo_record_001", "record_revision_id": "demo_record_revision_001", "record_status": "draft", "subject": { "display_name": "虚构样例对象甲",
 "scenic_id": null, "poi_id": null, "poi_namespace_type": 0, "poi_match_status": 0, "identity_status": "unknown" }, "topic": "建筑主题结构示意",
 "guide_title": "样例对象的讲解草稿",
 "guide_text": "【结构示意,非景区事实】正文将按已核验的对象范围组织;当前没有可引用事实。",
 "guide_content_type": 1, "original_excerpt": null, "excerpt_source_url": null, "original_content_type": 0, "missing_reasons": { "original_excerpt": "not_requested", "excerpt_source_url": "not_requested", "poi_id": "not_found" }, "source_dirs": [ { "candidate_id": "demo_candidate_001", "url": "https://example.org/demo/guide", "publisher": null, "platform_category": "unknown", "relation_status": "candidate_only", "acquisition_status": "not_acquired", "retrieved_time": null } ], "rights": { "access_decision": "not_evaluated", "save_decision": "not_evaluated", "model_processing_decision": "not_evaluated", "adaptation_decision": "not_evaluated", "redistribution_decision": "not_evaluated" }, "media_artifact_id": null, "asr_revision_id": null, "review_status": "unreviewed", "eligible_for_sealing": false}
14. 用证据链连接字段、事实和来源
一份资料里可能同时出现建筑介绍、票务信息、作者推测和广告文案。把整页 URL 挂在记录后面,并不能回答“始建年代来自哪一段”。我们应把来源、证据、断言与字段分开保存,让同一条材料可以支持不同字段,也让一个字段可以接受多条材料的支持或反证。
从实际取得资料到可定位证据
获取阶段记录请求地址、最终地址、访问方法、实际读取时刻、解析器版本和权利快照。原始对象是否保存、保存什么范围,要服从用途与保留策略;没有保存完整 HTML,就不能给用户一个并不存在的“原始页面下载”。用户上传文件则标为用户提供,不伪造网页发布者或网页读取过程。
抽取阶段保存文本段、表格单元、文档页段或媒体时间跨度。证据必须能定位:网页可以记录实际取得文本中的偏移与上下文锚点,PDF 可以记录页码与段落,媒体可以记录起止时间。DOM 选择器会随网页变化,最好与对应读取修订及文本锚点一起使用,不能拿今天的页面位置解释过去的摘录。
标准化阶段把抽取值转为字段约定的单位、精度和类型,同时保留原始值与转换规则。修订阶段才把值、来源和规则固定为记录版本。获取失败是获取缺口,解析失败是抽取缺口,材料相互矛盾是事实缺口;将三者统称“未找到”会损失重要信息。结构化模型输出可以约束 JSON 形状,却不能证明模型实际读过资料,更不能凭格式正确证明值为真。3
证据支持的是有范围的断言
source_id 标识来源身份,source_revision_id 标识一次取得或复用所依据的内容修订。evidence_id 指向该修订中的具体片段;assertion_id 标识要表达的结论,断言修订保存本次措辞、时间限定、单位与支持关系。最终字段的 provenance,即数据来历,连接字段值、精确断言修订、证据与转换方法。
支持关系需要注明 supports、contradicts 或 context。背景介绍只能作上下文,不能被当作直接支持。多篇报道重复转述同一材料,也不是多个独立来源;如果发现相反材料,应保留冲突组和双方的适用范围,不用“多数网页都这样写”投票消除反证。
字段级来历还要区分直接抽取、规则转换、确定性计算和编辑性标题。标题可以由编辑组织,但标题里的事实性表述仍需支持。计算值则绑定固定数据快照与方法,不能只引用输入记录的某一条网页。记录级来源集合便于阅读,字段级链路负责核验,两者互补而非替代。
下面第二个 JSON 同样是虚构结构示意,专门展示尚未取得材料时的合法草稿形态。它没有创建读取修订、证据或封存快照;null 是真实边界,而非待模型猜测的空位。
{
 "schema_version_name": "field_provenance_draft_demo_v1", "project_id": "demo_project", "task_id": "demo_task_001", "record_revision_id": "demo_record_revision_001", "field_key_name": "construction_year", "raw_value": null, "standardized_value": null, "unit_code": "year", "missing_reason": "not_requested", "source_candidate": { "candidate_id": "demo_candidate_001", "requested_url": "https://example.org/demo/guide", "candidate_status": "discovered", "acquisition_status": "not_acquired" }, "source_revision_id": null, "retrieved_time": null, "evidence_links": [], "assertion_draft": { "assertion_id": "demo_assertion_001", "assertion_revision_id": "demo_assertion_revision_001", "assertion_type": "factual", "assertion_text": "样例对象的始建年代待核验,当前不作年代结论。",
 "assertion_value": null, "verification_status": "candidate", "time_qualifier": { "valid_from": null, "valid_to": null, "status": "unknown" }, "support_status": "unsupported", "conflict_group_id": null }, "transform": { "method_version_name": "year_field_validation_v1", "derivation_ref": null, "execution_status": "not_run" }, "snapshot_draft": { "dataset_revision_id": "demo_dataset_revision_001", "revision_status": "draft", "record_manifest_ref": null, "content_hash": null }, "rights_snapshot_ref": null, "review_status": "unreviewed", "report_eligibility": "blocked_missing_evidence"}
真正取得资料后,服务应追加读取修订与证据,再产生有支持的断言修订;不得原地把示例草稿改成“已核验”。如果材料过期、删除或不再允许检查,证据资产状态也要变化,旧报告保留最小墓碑并说明核验受限。证据内容哈希只能证明指定字节没有变化,不能证明网页说法正确;来源知名度同样不能替代事实核验。
15. 数据模型:为什么不能只保存聊天记录
聊天是入口,却不适合成为唯一事实库。同一任务的进度可以显示在两段对话里,同一文件可以被多次引用,一条消息也可能编译出多个任务。如果只在消息上放一个 task_id,后续的编辑、停止和成果追溯都会出现歧义。
关联与修订,比一份巨大 JSON 更重要
conversation_id 标识会话,message_id 标识逻辑消息,message_revision_id 标识该消息的一次内容版本,turn_id 标识一次用户提交及关联回复。会话与任务通过关系表多对多关联;消息片段则精确绑定消息修订、part_id、轮次、任务和 request、progress、output 用途。绑定只提供获授权的展示关系,不复制任务,也不扩大来源或文件访问权。
用户修改消息时,应追加修订,而不是重绑正在执行的计划。定稿内容不可覆盖;组装中的草稿可以有界更新,最终封闭为定稿或中断版本。任务下面再分 run_id、work_item_id、step_id 与 agent_run_id,分别回答哪次运行、哪个范围单元、哪个执行节点和哪次模型调用。暂停恢复可以建立同任务的新运行;终态续做建立带父任务引用的新任务,旧成果包不随之改变。
数据、报告和文件也需要精确版本。dataset_revision_id 固定字段方案与记录清单,report_revision_id 固定正文与断言清单,artifact_id 指向由这些版本生成的文件。聊天链接保存资源 ID、所属修订与哈希,不嵌入永久下载地址;再次点击应重新鉴权,不得偷偷跳转“最新版本”。大正文、媒体和清单存私有对象存储,应用库保留可查询的关系、版本、水位与私有引用。
应用 SRC 与行业 DWD 是两个模型
应用库示例名为 cloudsearch_app,沿用 SRC 业务源层规范,操作实体命名 src_opr_*_f,成果实体命名 src_prd_*_f,均为非分区表。这里的任务与会话不应被迫继承景区批次、行业主档或 travel_date。景区 DWD 的天级分区是另一种业务组织方式,其日期表示采集批次业务日期,而不是游客出游日。
下面只给两个核心建表示例,不复制完整六表,也不是可直接投产的迁移包。假设 MySQL 8.0.16+、InnoDB、既有库及 UTC 连接;每个字段和表都有注释。CHECK 检查行内形状与枚举,不保证状态迁移、权限或跨表引用成立。5
-- 结构示例:不创建数据库,不在本文执行;生产迁移还需独立评审。
CREATE TABLE cloudsearch_app.src_opr_task_f (
 project_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '项目隔离范围ID',
 task_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '云端根任务ID',
 authority_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '唯一执行权威ID',
 parent_task_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NULL COMMENT '终态续做的父任务ID;同项目无环',
 task_mode VARCHAR(24) NOT NULL COMMENT 'quick_search搜索 research研究 dataset数据 hybrid混合',
 task_status VARCHAR(24) NOT NULL DEFAULT 'draft' COMMENT 'draft草稿 ready预检通过 queued排队 running执行 pausing暂停中 paused已暂停 stopping停止中 stopped已停止 completed终结无技术失败 partial_failed部分失败 failed整体失败 cancelled未执行取消',
 spec_version_name VARCHAR(64) NOT NULL COMMENT 'TaskSpec版本名',
 task_spec_json JSON NOT NULL COMMENT '根含mode requirement_text scope output execution budget policy_refs;不含秘密',
 plan_revision_no BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '计划修订号',
 plan_hash CHAR(64) CHARACTER SET ascii COLLATE ascii_bin NULL COMMENT '冻结计划规范内容SHA-256;草稿可空',
 current_run_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NULL COMMENT '当前或最近运行ID',
 cancel_generation BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '取消隔离代次',
 task_cap_minor_amt BIGINT UNSIGNED NOT NULL COMMENT '费用硬上限;币种最小单位',
 currency_code CHAR(3) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '金额币种代码',
 event_seq_no BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '权威任务事件水位',
 lock_version_no BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '乐观并发比较交换版本',
 created_by_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '创建主体ID',
 created_time DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '创建UTC时刻;连接须设UTC',
 updated_time DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '服务显式更新UTC时刻',
 finished_time DATETIME(3) NULL COMMENT '执行终态时刻;不表示报告获批或写库成功',
 PRIMARY KEY (project_id, task_id), KEY idx_task_queue (project_id, task_status, created_time, task_id), KEY idx_task_parent (project_id, parent_task_id), CONSTRAINT ck_task_mode CHECK (task_mode IN ('quick_search','research','dataset','hybrid')), CONSTRAINT ck_task_status CHECK (task_status IN ('draft','ready','queued','running','pausing','paused','stopping','stopped','completed','partial_failed','failed','cancelled')), CONSTRAINT ck_task_shape CHECK (JSON_TYPE(task_spec_json)='OBJECT' AND plan_revision_no>=1 AND cancel_generation>=1 AND lock_version_no>=1), CONSTRAINT ck_task_plan CHECK (task_status IN ('draft','cancelled') OR plan_hash IS NOT NULL)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci
COMMENT='非分区应用任务表;聊天关联和质量交付状态独立';

CREATE TABLE cloudsearch_app.src_prd_record_field_provenance_f (
 project_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '项目隔离范围ID',
 provenance_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '不可覆盖的字段来历ID',
 task_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '产生本字段来历的任务ID',
 record_revision_id VARCHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '精确记录修订ID;逻辑引用另校验',
 field_key_name VARCHAR(128) NOT NULL COMMENT '已注册schema中的字段键;不是任意SQL标识符',
 field_value_json JSON NOT NULL COMMENT '标准化字段值;未知存JSON null并给出原因',
 missing_reason_code VARCHAR(32) NULL COMMENT 'not_found未找到 not_disclosed未披露 not_applicable不适用 access_blocked访问受限 source_conflict冲突 parse_failed解析失败 not_requested未请求',
 source_revision_refs_json JSON NOT NULL COMMENT '精确来源修订ID数组;无实读时为空',
 evidence_links_json JSON NOT NULL COMMENT '证据数组;含supports支持 contradicts反证 context背景及支持范围',
 assertion_revision_refs_json JSON NOT NULL COMMENT '精确断言修订ID数组',
 derivation_ref VARCHAR(512) NULL COMMENT '确定性转换或计算的私有方法记录引用',
 rights_snapshot_ref VARCHAR(512) NULL COMMENT '精确用途权利快照私有引用',
 review_status VARCHAR(32) NOT NULL COMMENT 'unreviewed未审 machine_checked机检 pending_review待审 needs_revision需改 approved获批 rejected拒绝 legacy_pending_verification历史待核',
 provenance_hash CHAR(64) CHARACTER SET ascii COLLATE ascii_bin NOT NULL COMMENT '版本化规范JSON的SHA-256;只校完整性',
 created_time DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '修订创建UTC时刻',
 PRIMARY KEY (project_id, provenance_id), UNIQUE KEY uk_field_revision (project_id, record_revision_id, field_key_name), CONSTRAINT fk_provenance_task FOREIGN KEY (project_id, task_id) REFERENCES cloudsearch_app.src_opr_task_f (project_id, task_id), CONSTRAINT ck_provenance_arrays CHECK (JSON_TYPE(source_revision_refs_json)='ARRAY' AND JSON_TYPE(evidence_links_json)='ARRAY' AND JSON_TYPE(assertion_revision_refs_json)='ARRAY'), CONSTRAINT ck_provenance_missing CHECK (missing_reason_code IS NULL OR missing_reason_code IN ('not_found','not_disclosed','not_applicable','access_blocked','source_conflict','parse_failed','not_requested')), CONSTRAINT ck_provenance_null CHECK ((JSON_TYPE(field_value_json)='NULL' AND missing_reason_code IS NOT NULL) OR (JSON_TYPE(field_value_json)<>'NULL' AND missing_reason_code IS NULL)), CONSTRAINT ck_provenance_review CHECK (review_status IN ('unreviewed','machine_checked','pending_review','needs_revision','approved','rejected','legacy_pending_verification'))) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci
COMMENT='非分区字段级来历修订表;只对任务示范物理复合外键';
应用还需要来源身份与读取修订、证据、断言、数据修订、报告修订、产物、审核、授权及预算账本等实体。逻辑外键必须带 project_id,校验记录属于数据集、运行属于任务、文件属于精确修订,不能因 ID 不透明且全局唯一就省略鉴权。清单可以移出库,但唯一键与关系不能全部藏入不可检索 JSON。
ID 按不透明字符串处理;UTC 时间在数据库用 DATETIME(3),API 用带 Z 的 RFC 3339。BIGINT 计数、序号与代次在 JSON 中用十进制字符串,避免前端整数精度损失。预算账本独立登记预留、确认、释放、调整和未知费用;任务表的上限不是实耗,超时也不是零费用。这样的分层使聊天展示、事实质量、执行状态和财务记录各有自己的依据。
16. 数据清洗、去重与可复现分析
数据清洗最危险的错误不是漏掉空格,而是悄悄改变对象和事实。原始值、标准化值与展示值应该分层保存。例如可以为检索建立去空白的比较键,却不能因此覆盖外文名称;可以统一单位,却不能删除“约”“截至某年”等限定。
四种重复,四种处理
精确重复是相同规范内容或相同字节,可用 SHA-256 指纹筛出,但指纹必须注明规范算法版本。近似重复是正文高度重叠,可能只有标题或标点不同,适合进入候选组。语义重复是措辞不同却讨论相同问题,需要进一步检查对象、时期和范围。身份重复则是两个记录可能指向同一 POI,不能由文本相似度直接决定。
页面版本也不应当被“去重”掉。同一 URL 今天修改价格或开放安排,是新读取修订;多个镜像 URL 可能属于同一转载家族,但其中也可能出现编辑差异。URL 规范化只能按已知规则去除无业务意义的跟踪参数,不能一概删除查询串,把分页、语言或版本参数抹掉。内容指纹、对象键、来源家族与修订关系应分别保存。
缺少可靠业务键的记录先隔离于正式合并过程。近似与语义判断只能提出建议,不能自动保留最长文本、选最新抓取值或平均冲突年代。执行清洗前应生成 dry run,即不落正式修订的差异预览,列出将改变的字段、候选合并、冲突与受影响引用;批准后追加修订,记录方法版本和输入输出哈希。
模型负责解释,正式数值交给确定性方法
正式统计必须绑定封存数据快照,明确行粒度、过滤条件、单位和分母。某字段为空时,不能把它作为零参与平均;统计覆盖率时,未检查记录也不能被算成“没有缺失”。以下纯 Python 示例可以独立运行,不调用模型、数据库或网络,只使用前期三个批次的公开归纳数量。
这里只明确输入续采 912 条的摘录缺失数量,另外两批的该指标留空,表示本段计算输入没有展开其摘录覆盖核验,不是判断它们没有摘录。结果因此区分已知缺失、未展开覆盖和完整缺失率;白名单方法只有一个,不接受任意表达式。
from decimal import Decimal, localcontext

METHOD_VERSION = "excerpt_missing_summary_v1"


def summarize_excerpt_missing(rows):
 seen = set() total = covered = missing = 0 for row in rows: batch_id = row["batch_id"] if not isinstance(batch_id, str) or not batch_id or batch_id in seen: raise ValueError("批次ID为空或重复")
 seen.add(batch_id) qty = row["content_qty"] absent = row["excerpt_missing_qty"] if type(qty) is not int or qty < 0: raise ValueError("数量必须是非负整数")
 total += qty if absent is None: continue if type(absent) is not int or not 0 <= absent <= qty: raise ValueError("缺失数量超出本批数量")
 covered += qty missing += absent unknown = total - covered with localcontext() as ctx: ctx.prec = 40 # 只有分母非零、覆盖完整时才给完整缺失率;不是心算或插补。
 rate = None if total == 0 or unknown else str( (Decimal(missing) / Decimal(total)).quantize(Decimal("0.000001")) ) return { "method_version_name": METHOD_VERSION, "denominator_name": "输入批次的内容记录数",
 "denominator_qty": str(total), "covered_records_qty": str(covered), "unknown_records_qty": str(unknown), "known_missing_qty": str(missing), "complete_missing_rate": rate, "rate_status": "unknown" if total == 0 or unknown else "known" }

METHODS = {METHOD_VERSION: summarize_excerpt_missing}


def compute(method_name, rows):
 if method_name not in METHODS: raise ValueError("方法不在白名单")
 return METHODS[method_name](rows)

batch_summary = [
 {"batch_id": "initial", "content_qty": 80, "excerpt_missing_qty": None}, {"batch_id": "expanded", "content_qty": 2959, "excerpt_missing_qty": None}, {"batch_id": "continued", "content_qty": 912, "excerpt_missing_qty": 912}]
print(compute(METHOD_VERSION, batch_summary))
生产计算还要在外层登记输入快照哈希、schema 版本、方法版本、输出哈希和执行环境;这不是由模型填写的“已计算”声明。Decimal 用于需要明确精度的十进制运算,金额还须声明币种和舍入规则。聚合、分组、筛选和排序可以扩展成小型命名计算白名单,但不能开放任意 SQL、Python eval 或 shell。图表必须复用同一结果修订,避免报告正文和图中数字来自不同版本。
17. 报告生成:让每个重要结论回到资料与计算
报告不是把聊天回答排版成 PDF。它应当先固定要回答的问题、目标受众、资料截至时点、用途、提纲和引用粒度,再从明确版本的数据与断言生成正文。研究型任务可以只有报告,数据型任务可以只有数据文件;两者同时存在时,报告绑定数据修订,而不是实时读取不断变化的“最新数据”。
不同结论,需要不同依据
断言分为四类。factual 是事实性表述,依靠实际读取且范围相符的证据;calculated 是计算结果,依靠固定快照、确定性方法与结果记录;analytical 是解释性判断,需要标明采用的材料、比较框架与推理限制;recommendation 是建议,需要说明目标、约束和适用条件。不能给一段建议挂上官网链接,就把它包装成官网结论。
报告段落应固定断言修订和证据清单。事实引用定位到页段、文本跨度或媒体时间,而不只是域名;计算引用定位到数据快照与方法。直接引语只能来自真实摘录,不把整理正文加引号冒充原话。反证也要进入清单:若两条材料讨论的时间或对象不同,可以解释差异;若冲突尚未解决,就保留不确定性,不能让写作阶段偷偷选择更顺口的版本。
资料年龄同样属于结论的一部分。发布日期、实际读取时刻和报告截至时点不能混用;来源未披露发布日期就保留空值。复用缓存时,保留原读取修订,再记录复用时刻、年龄与允许策略,不把缓存访问伪装成新读取。对于时效性信息,超龄材料应触发重新获取或明确限制;历史背景也不能因“不常变化”就省略版本。
质量说明要覆盖缺失、来源独立性、定位能力、冲突、时效、计算和权利,不用单一分数掩盖问题。来源已知不代表真相已知,哈希一致不代表内容准确;缺少证据的事实应删去、降为明确问题或阻断相应用途,而不是在报告末尾统一加一句免责声明。
七种审核状态与三种报告状态互不替代
review_status 有七态:unreviewed 未审核,machine_checked 已机器检查,pending_review 待审核,needs_revision 需要修改,approved 指定用途获批,rejected 被拒绝,legacy_pending_verification 历史资料待核验。机器检查可以验证格式、引用存在和计算一致性,不能代替人审,更不能把导入成功算成人工确认。
报告自身的 report_status 只有 draft、ready、exported。草稿可以展示,但需带质量状态;ready 表示指定用途的门禁通过;exported 表示这个版本已生成文件,不表示已经公开发布或完成数据库投递。低风险用途若按策略允许机器检查后导出,应保留 machine_checked 与相应策略决定,不能伪造 approved。
预览、渲染和导出分别产生操作记录与文件版本。页面预览成功不改变审核决定,导出时仍要核对断言支持范围、反证、图表输入哈希、文件哈希和作品用途。后续修改追加报告修订,旧文件与旧清单保持对应;若引用证据撤权,应撤销相关访问或标记受限,而不是悄悄换一条链接继续宣称可检查。
18. 文件交付、六表映射和可选MySQL投递
对于多数用户,拿到可理解、可继续使用的文件,就已经完成主要交付。业务数据库连接应是可选能力,而不是聊天研究的前置条件;没有连接器时仍可以生成数据与报告,数据库交付摘要标为 absent,不能因此将任务判为失败。
一个成果包要有六类信息
成果包应包含六类信息:正文或数据本体;字段 schema 与业务口径;来源、证据和字段来历;质量、缺失与权利说明;精确版本及文件哈希清单;交付状态与回执。它们不一定是六个文件,但必须让接收者知道“拿到了什么、如何解释、可追到哪里、有什么限制、是哪一版、是否真正送达”。
数据集还要声明行粒度、业务键、字段类型、单位、精度、枚举和缺失规则。JSON 可以保留复杂来历,CSV 适合交换扁平数据,XLSX 适合人工查看;无论哪种格式,都不应丢掉稳定 record_id 与记录修订引用。文件名采用不含用户输入路径的安全模板,例如 cloudsearch_dataset_demo_r1.csv,长度有界,避开路径分隔符、控制字符和危险后缀,显示名称与对象键分离。
CSV 要按 RFC 4180 风格处理逗号、双引号和字段内换行:字段内双引号写成两个双引号,长文本可以整体加引号,不能靠逐行切割读取。10编码明确为 UTF-8;面向需要 BOM 的表格软件时,可以单独生成 UTF-8 BOM 版本,并在清单中注明,不能让消费者猜编码。
安全导出还要防公式注入。对字符串检查危险的公式前缀及其前导空白、制表符等绕过形式,按明确策略生成展示安全值;合法数值列按 schema 写数值,不粗暴篡改所有负数。转义会改变展示字节,因此应保留获准交付的规范原始值文件,并登记转换策略与受影响字段,不把转义后的 CSV 当成原始数据。
CSV 空单元格无法可靠区分 NULL 与真正空字符串,可以附带以 record_id、记录修订和字段键关联的缺失 sidecar 文件,记录空值标识及原因。含换行正文使物理行数大于记录数,统计必须来自解析后的逻辑记录;清单分别保存记录数、缺失数、重复键检查结果和文件字节哈希。原始证据若权利受限,则不随规范值文件打包;用户记录和成果原件也不应上传公共地址供博客引用。
六张 DWD 表,表达的是六种关系
前期景区成果按六张行业 DWD 表组织。来源表 dwd_prd_scenic_guide_source_di 有 3,882 行,保存来源身份、机构、读取时间和访问方式;内容表 dwd_prd_scenic_guide_content_di 有 3,951 行,保存五个核心字段的业务映射、对象范围、内容类型和权利状态;事实表 dwd_prd_scenic_guide_fact_di 有 24,651 行,每行表达一条限定范围的属性和值。
内容来源关系表 dwd_prd_scenic_guide_content_source_rel_di 有 7,373 行,表示一篇整理正文可以依靠多个来源,并区分是否为原文摘录来源;事实来源关系表 dwd_prd_scenic_guide_fact_source_rel_di 有 27,126 行,连接具体事实与支持页面;采集任务表 dwd_prd_scenic_guide_collect_task_di 有 296 行,记录批次内对象的采集状态、产出数量与缺口。任务跨批次计数,所以不能把 296 当成不同景区数;内容覆盖的是 292 个主档对象。
来源行数也不等于 URL 数。全体归纳中不同 URL 为 3,859,域名为 955,而同一 URL 可以在不同景区关联中获得不同来源 ID。六表数量是文件成果的归纳口径,不是本节执行查询后的数据库回执。原 DDL 顶部的首批数量只描述 80 条首批内容,不能用它覆盖后续合并规模。
行业主键包含批次、实体键和 travel_date,关系校验也须带同批次、同分区及对象身份。travel_date 是 YYYYMMDD 采集业务日期,具体默认规则按批次确定,不是发布日期或游客行程日期。分区 InnoDB 表的这些关系由导入校验维护,不照搬应用表的物理外键。内容数量、事实数量和来源数量应按各自粒度重算;912 条缺摘录记录的来源关联仍可存在,但摘录标识不能虚构为真。
数据库投递要把“未知”当作真实结果
可选 MySQL writer 应与应用状态库、浏览器执行和普通前端隔离,通过独立账号、网络策略与必要时的授权 gateway 访问目标。权限只覆盖批准的库、表和命名 DML;预检明确指定示例库 biz_data 或获准目标,实际只读核对 schema、列类型、键、权限与拟写范围,不接受聊天文本中的任意 SQL,也不自动建库改表。
投递前固定 manifest 哈希、映射版本、全量预期键、行哈希和目标基线指纹。schema 映射只从白名单字段生成,值使用参数绑定;参数不能用于替代表名,因此标识符更需事先注册。批次与事务有界,每个事务固定自身清单和同事务回执,不能把多次已提交批次说成一个原子全量投递。若需要全包一致性,可另设计经过批准的暂存与发布机制,而不是无限扩大事务。
建表迁移与投递 DML 必须分开。MySQL 的 DDL 存在隐式提交,不能放入“失败就全部回滚”的数据事务中。6 例如不满足一般 CHECK 约束可能出现错误码 3819,这只是 MySQL 约束诊断示例,不是某个用户数据库的实际报错记录;处理应记录约束与安全错误类别,不能公开连接串或账号。
最关键的故障发生在 COMMIT 发出后、响应返回前。网络断开时,数据库可能已提交,也可能未提交,writer 必须记录 commit_unknown,不能直接算失败重写,更不能凭目标 COUNT 相等算成功。数据库投递与应用状态记账不是分布式原子事务,状态库里缺少成功事件,也不能证明目标没有提交。
可靠做法是在目标同一个 DML 事务内写入唯一投递回执,回执绑定 delivery、manifest、映射版本和本事务预期键清单哈希。对账先确认旧事务是否结束,再用一致读核回执、全部精确键、每行哈希、范围及基线变化。只读到若干相同记录不足以证明这次事务成功:它们可能早已存在,所以预检指纹与同事务回执不能省略。
完整回执与全键内容精确匹配后,才可记 reconciled_committed。对于明确的追加事务,旧事务已结束、无回执且全部预期新增键不存在,才可能确认 reconciled_not_committed;涉及更新时,还需证明目标保持批准前的基线,不能套用“键不存在”规则。部分存在、哈希冲突、回执缺失但记录相同、目标不可达、旧事务仍在途或并发外部修改导致无法重建历史,都应保持未知并进入人工处置,而不是盲目重试。
因此,文件已生成、报告已导出、数据库已提交和人工已批准应独立显示。交付账本可以经历 prepared、preflight_failed、writing、committed、failed、commit_unknown、reconciled_committed、reconciled_not_committed;未知状态禁止自动重写。对用户而言,准确展示“文件可下载,数据库提交待对账”,比一个没有根据的全绿成功提示更有用。
19. 接口设计:把聊天、任务和阅览真正连接起来
聊天界面可以很轻,但服务端不能把“收到一句话”“开始执行”和“交付成功”合成一个状态。云搜的接口设计要把这三件事拆开:conversation 保存对话,message 保存输入及修订,task 管理执行;viewer 则只是任务旁边的只读窗口。用户没有打开右栏,研究也可以继续;用户打开右栏,没有实际浏览器会话就应看到“尚未启动”,而不是偷偷创建任务。
消息先落盘,再讨论是否执行
控制接口统一使用 /api/v1。鉴权主体、X-Project-ID、路径或正文中的项目与对象所属项目必须一致;跨项目不可见对象默认返回 404,不能靠前端隐藏按钮实现隔离。POST /conversations 创建对话,POST /conversations/{id}/messages 接收文字、模式选择和已授权附件引用。服务端先在同一事务中保存消息、初始修订和会话水位,再判断是直接答复、澄清,还是编译研究计划。智能识别是前端选择策略,后端仍落到既定四种模式;收到消息并不等于调用 start。
重发有两层防护。Idempotency-Key 是幂等键,即网络重试不能重复产生有效副作用;client_message_id 是客户端为同一条输入生成的稳定身份。相同作用域、相同键、相同请求返回原响应,换请求则拒绝;即使换了幂等键,同一消息 ID、同一内容仍返回已有消息,不再付费编译。同 ID 异内容必须冲突。后端应按版本化的规范化规则计算请求哈希,覆盖文字、模式和附件修订引用,而不是只比展示文本;哈希用于判重,不代替权限检查。
消息去重之后,还需要解决“消息已保存,编译工作尚未派发”的故障窗口。可以在同一个短事务中登记消息和待处理的编译工作,调度器从持久记录领取;也可以采用事务 outbox,把待派发事件与消息一起提交,再由后台可靠投递。编译逻辑使用稳定的请求身份,结果受理也有幂等回执。仅在 HTTP 响应成功以后由前端触发下一步,会在断线时漏执行;仅靠重试重新调用模型,则可能重复计费。模型调用已经发送却响应未知时,仍应按独立费用账本处理,不能由消息唯一键假定供应商调用只发生一次。
编辑也不能覆盖过去。追加消息修订要携带 base_revision_id、base_hash 和 If-Match。后者是 HTTP 条件更新头:只有客户端所见版本仍有效才接受修改,避免两个标签页互相覆盖。旧任务继续绑定旧输入和成果。条件冲突返回 412,缺必需版本返回 428;隐藏消息或软删对话只改变可见性,不级联停止任务。
较慢操作返回 202 和持久化的 operation_id、查询地址,客户端可以用 GET /operations/{id} 追踪。ACK 是已接收确认,不是编译、执行或导出完成;操作成功也不自动意味着任务完成、报告通过或投递提交。排队必须有限:设置队列容量、等待期限和取消路径,到期明确失败或要求重新确认,不能用永远旋转的进度条掩盖资源不足。生成中的文字可以作为有界草稿片段展示,必须限制大小、速率和生命周期;原始模型流不包含隐藏推理,也不充当执行进度的真相。
控制命令与事件各有职责
POST /tasks 创建 draft;compile-plan 生成候选计划,preflight 固定精确计划、配置和授权快照。预检中的 static_only 只检查静态条件,不能声称浏览器已连通;需要探测时,另经授权采用 authorized_probe。计划、权限变化或预检过期,应重新检查。start 携带预检身份、计划哈希、版本和幂等键,由 ready 进入 queued,worker 实际领取才进入 running。
pause 先禁新动作和有价请求,在安全点收敛;resume 只恢复 paused 的任务,核对检查点、权限和预算后创建新 run。stop 先持久递增取消代次,再阻断领取和动作,不能承诺远端调用瞬时撤回。终态继续工作使用 continue-as-new 创建带父任务引用的新 draft,重新编译预检,不改旧封存包。
worker 是云端执行进程,不是前端用户。注册、领取、心跳、检查点、动作许可和结果协议仅向批准设备身份开放。租约是限时执行权,lease_epoch 是用来拒绝旧执行者的栅栏版本;结果还须匹配任务、run、计划哈希、取消代次和尝试号。结果上传后先校验,再登记回执、索引和事件。同身份同哈希重放只返回原回执,异哈希拒绝,停止后的迟到结果进入隔离区,不变成聊天成功卡。
SSE(Server-Sent Events,服务端单向推送事件)适合通知前端变化。GET /tasks/{id}/events 才是执行权威流,会话流只是片段及绑定变化的投影。下面是说明用假设事件;具体事件类型应由共享 schema 注册,ID 和计数器均用字符串:
id: task_demo:17
data: {"authority_id":"auth_demo","task_id":"task_demo","event_seq_no":"17","event_type":"progress","resource_revision":"9","server_time":"2026-11-12T16:00:00.000Z"}
事件 id 采用 task_id:event_seq_no。聊天 progress part 引用同一个 task/event,不生成第二套编号。来源片段同样引用 canonical schema(共享的唯一规范化结构定义)中的 source_id、source_revision_id,而非把不带版本的 URL 当来源身份。客户端按各任务水位去重,用 Last-Event-ID 重连补缺,心跳不占序号,过滤不重编号;日志已过期返回 410 时,先读取带 snapshot_event_seq_no 的一致快照再续订。快照与水位必须来自同一可验证读视图,旧事件也不能回退较新的资源状态。
阅览票据不能变成控制通道
POST /browser-sessions/{id}/viewer-tickets 签发绑定主体、项目、会话、客户端实例和阅览范围的短期单次兑换票据。单次限制的是兑换,不是每帧都重签。兑换应通过受控 HTTPS 请求正文或授权头传递,再换成短期阅览授权;确切兑换路由须在 OpenAPI(机器可读的接口描述)中补齐,不能把设计建议冒充既有接口。
原生 EventSource 不能任意设置 Authorization 请求头,标准构造选项仅包含 withCredentials。9若采用头鉴权,可用 fetch 读取 SSE 并实现解析、重连及水位管理;也可以让同站 relay 作为中继,用安全、HttpOnly、受限路径的 Cookie 承载短期授权,浏览器只连同站接口。兑换请求应核验 Origin 和防跨站请求伪造机制;relay 逐次检查 scope、到期与撤销,不把浏览器 Cookie、CDP 调试地址或长期密钥传给客户端。任何方案都不能把票据放进查询参数来绕过头限制。授权到期暂停阅览并重新核权,刷新帧与刷新授权是两件事。
meta、snapshot、subscribe 只读已有受控帧。界面显示 preview_mode=snapshot、captured_time 和 stale,过时帧不冒充当前页面。撤权应阻断旧票据和订阅;关闭右栏或删除该阅览订阅只 unsubscribe,不 stop 任务、不 reload 来源、不切换控制 Owner,更不允许 viewer 发起无用户授权的任务。
20. 安全、版权与授权为什么必须进入执行链
研究平台会同时接触用户文件、第三方网页、模型供应商和长期产物。安全不能只靠登录页,也不能靠模型“不要泄密”的提示词。它必须约束每一次真实调用,以及资料从读取到发布的每一次用途变化。
权限、秘密与执行进程分开
五个角色不是权限高低的一条直线。admin 管成员、设备与策略,不天然拥有审核或写库权;operator 创建、编译、控制任务;reviewer 审核精确修订及用途;data_engineer 管结构、清洗、封存和另授权的投递对账;reader 查看获准内容,下载、原件和 viewer 仍另核范围。worker 是设备主体,不是第六个人员角色。角色组合不免除高风险审批,团队场景应分开发起人与批准人。
credential vault 是后端保管秘密的凭据库,业务配置只保存 secret_ref。模型、搜索、对象存储、设备和选配 writer 的秘密不进入 Web 构建、聊天、SSE 或截图。浏览器进程也不应拿到 writer 密码:它访问的网页是外部代码,权限必须比控制面更窄。Playwright 的 BrowserContext 可隔离 Cookie 等会话数据,但并不是操作系统安全边界1;浏览器还需要非特权进程、沙箱或容器、资源限制和独立出口。
不可信页面不能给自己加权限
提示词注入,是网页或附件把“忽略规则、读取秘密”等指令伪装成研究材料。仅删除可疑文字并不可靠:执行器必须把外部内容当数据,工具只开放批准的命名操作,参数经 schema 和语义校验。确需代码分析时用 AST,即代码语法树,检查允许结构,不能直接 eval 或执行任意 shell。模型工具调用只是申请,最终授权和执行仍由服务端决定4。
SSRF 是服务器被诱导访问内部资源。只拉黑几个域名或私网 IP 不够,DNS 解析变化、重定向和页面子资源都可能绕过入口检查。每跳解析和目标地址、iframe、弹窗、下载及 WebSocket 都要纳入出口政策,网络层再阻断回环、私网、链路本地和云元数据地址;浏览出口不能继承业务数据库的私网许可8。阻断应留下可解释原因,而不是将失败页面编成“未发现信息”。
诊断 trace 是浏览器动作回放资料,可能包含敏感页面与会话内容2。默认应最小采集、短保留、受限查看,日志不记录 token、Cookie、完整连接串或受限正文。审计记录谁对哪个版本作了什么决定,不等于无限保存整个网页。
能访问,不等于能保存和传播
版权门禁应分别核准访问、保存原文、截图、模型处理、引用、改编、团队分享和公开分发。下载完整媒体、处理个人信息、重新发布作品不能自动继承“公开可读”的许可;工程依赖的开源许可证则另管分发义务,不能拿软件许可替代来源内容授权。这是用途治理方案,不是法律合规保证,疑义交相应治理人员判断。
P0 的截图不能承诺遮罩永远可靠。账户、支付、个人资料等敏感页面应禁帧;无法可靠确认脱敏时不提供帧,而不是先发送再让用户关窗。需要登录或验证时,另申请指定动作、期限和会话的人控 grant,即临时授权记录。批准后冻结 Agent 动作、核在途操作、递增 Owner(会话控制权持有者)栅栏,专门互动通道逐次核授权与动作序号;交还后撤 grant 并重新观察。通道未验收就保持 blocked,不能借“人工接管”绕验证码或网站权限。
如选 Electron,只做共享云状态的薄壳:启用 contextIsolation、sandbox,关闭 nodeIntegration,preload 只暴露白名单 IPC 并核 sender,限制导航和内容安全策略7。桌面包装不意味着本机 Python、SQLite 或研究 worker,也不改变后端鉴权职责。
21. 成本与容量:怎样避免无限搜索和预算失控
一个问题可能派生许多搜索、页面和重试。预算不是最后账单上的提醒,而是调度器决定下一步是否可发起的约束。容量也不能只写“支持多少任务”,因为浏览器内存、同域请求和模型额度会在不同位置成为瓶颈。
项目任务数、work 在途数、context 数、同域并发与速率、模型并发与 QPS(每秒请求数)、计算、上传及存储都应分别限额。等待模型额度的工作不能先占住域名令牌和浏览器槽位;采用分阶段、短期限资源许可,避免排队者长期锁资源。大任务要拆成有界工作项,项目间轮转并限制单任务占用,补搜次数、页数、深度和总时长都有上限。公平性要通过等待年龄和受控负载验证,不能从随机访问不同站点的快慢推出结论。
成本可以按下面的结构核算;这是公式,不是已测账单,金额交程序或电子表格计算:
C_task = Σ模型调用[(input_tokens × input_rate
 + output_tokens × output_rate) / billing_unit] + 搜索计费次数 × 搜索费率
 + worker/browser计费时长 × 相应费率
 + 计算渲染费用 + 存储请求费用 + 出网费用
 + 控制面分摊 + 审核工时费用
账本同时保存币种、税、计费单位、生效日和价目目录版本。未知单价或用量应标待核算,不填零,不虚构具体 token 价格。缓存命中、重试、失败和取消也可能收费,要区分供应商实际用量与内部估算。
reservation 是调用前原子预留的预算额度,用来阻止并发工作各自以为余额够用。发起后回填 actual,即实际费用,再释放确认未花的差额。预留不是收费,更不是任务开始就扣掉全额、结束再统一结算;计划可以估算总上限,但每次外部调用应独立取得额度。已发送而响应丢失的调用记 unknown,既不能当零,也不能因任务失败释放全部预留。对账依据 call_id、供应方记录和账单,重试另取额度,计划中也须为有限重试留余量。
额度耗尽停止新有价动作,保留已有成果并说明缺口;追加预算另授权。429 限流采用有上限的退避和抖动,限制重试次数与总期限,不能让所有 worker 同时恢复形成重试风暴。
容量起测可沿用文档的 API 2 vCPU/4 GiB、worker 4 vCPU/8 GiB、每 worker 两个 context。这只是实验起点,不是性能承诺。先验证两个任务、两个 context 的真实重叠,再逐级加压,记录页面复杂度、CPU、内存峰值、context 内存 p95 和数据库锁等待。p95 指百分之九十五观测不超过的值,不能把它当所有请求的上限。
SLO 是限定口径的服务目标。有效 API 月成功率 99.5%、持久 ACK p95 小于两秒、stop 持久化 p95 小于五秒、受控收尾三十秒内,均只能作为试点测量目标,需明确项目、来源、并发、统计窗口和异常分类。它们不保证任意站点研究完成时间,也不能靠删除来源拒绝或技术失败来美化分母。
22. 从文档到产品的分阶段实施流程
当前材料提供的是采集基础和设计契约,不是已经完成的研究平台。实施应沿一条真实链推进:一句未预置的问题能否形成有界计划,经授权搜索读页,再生成可追踪、可下载的成果?只完成界面动画或把模型连接到聊天框,都没有打通这条链。
阶段看出口证据,不按日历宣布完成
M0 的输入是聊天定位、资料边界和风险确认,由产品与架构主责、安全及 QA 复核。输出模式、ID、状态、API、权限、许可和采购阻塞清单。出口门禁是契约测试能表达“无实体名单研究”和“无目标数据库文件交付”,未授权任务不能进入真实执行。
M1 依赖 M0、身份服务及私有存储,由前端和 API 工程负责。输出真实消息持久化、附件安全处理、授权历史和 SSE 追赶。门禁要用双发、编辑冲突、重连、越权和恶意附件验证,前端显示发送成功不能替代后端持久 ACK。
M2 输入包括模型与搜索合同、云浏览器环境和出口预检,由后端/AI 工程主责、安全验收。输出真实 adapter(对接外部服务的适配器)、计划执行、多任务、多 context 和只读截图。出口必须证明未经人工贴 URL 的自动搜索、真实读页和调用用量;关闭 viewer 后仍运行。fixture 是人为准备的确定性测试材料,可以验证异常分支,但不能替代真实集成完成。
M3 依赖真实证据和用途许可,由数据与报告工程负责、reviewer 和 QA 复核。输出字段引用、固定 snapshot、确定性计算、报告修订和版本文件。门禁是缺值不猜、数字可重算、引用支持范围正确、产物哈希与下载权限一致;详细证据数据结构沿前文,不在这里另造一套。
M4 输入是持久状态、可注入故障的环境和预算账本,由调度与运维负责。输出停止栅栏、费用预留、检查点恢复及文件交付;选配 writer 由 DBA 另批准。门禁包括迟到隔离、并发预算不透支、无业务库仍能交付,以及未知提交拒绝盲重放。
M5 依赖前述出口、告警负责人和批准的试点范围,由安全与运维牵头。输出攻击测试、容量曲线、账单核对、服务目标、备份和回退演练。门禁只能放行验证过的项目、来源和并发范围;严重一致性风险要停派发,不能靠扩容掩盖。每阶段都受采购、站点许可、人员和整改依赖影响,不能据这些名称承诺开发周期。
十二个能力域落成工作包,而非十二个菜单
工程拆分可以用一条工作包清单追踪:W01 需求契约负责范围和澄清;W02 会话鉴权负责消息、附件和事件;W03 调度恢复负责租约、停止和幂等;W04 搜索模型 adapter 负责真实查询与用量;W05 浏览 viewer 负责隔离执行和阅览;W06 证据抽取负责字段与来源修订;W07 验证审核负责冲突与门禁;W08 分析负责固定快照计算;W09 报告文件负责渲染封存;W10 模板策略负责工具和用途授权;W11 选配连接器负责预检与对账;W12 运维预算负责容量、账本和恢复。每包都交代码、接口测试、真实或明确标记的 fixture 证据、降级及回退说明,八 Agent 的内部协作仍按前文展开。
仓库可以按以下边界组织,这是拟交付结构,不是已有代码:
apps/web/                 React + TypeScript聊天与只读panel
apps/control-api/         Express控制面、鉴权与持久事件
apps/desktop/ 可选薄壳
packages/contracts/       canonical schemas及TS/Python契约
packages/ui/ 无特权渲染组件
workers/python/           agents、adapters、jobs
services/viewer/ 受控帧与阅览授权模块
services/connectors/ 可选writer/gateway模块
migrations/mysql/ 应用状态迁移
policies/ 权限、出口、用途与预算
tests/ 契约、集成、安全、故障和负载测试
deploy/cloud/ 云镜像与部署配置
docs/runbooks/ 事故与恢复手册
目录名称不等于必须拆成微服务。可以模块化部署,但浏览器、秘密和 writer 的隔离边界不能省略。MySQL 保存权威应用状态,私有对象存储保存获准证据与 exports;导出模块按实际验收声明格式,不因目录存在就宣传所有格式。
P1 的真实 ASR、OCR、语音输入和实时浏览流应另设阶段:分别核媒体取得与处理许可、供应商协议、准确性或延迟测试、敏感内容和费用门禁。ASR 是音频转写,OCR 是图像文字识别,不应由旧媒体标签模拟。选配私网 gateway 也独立批准和交付,不成为主链依赖。这些阶段不自动包含定时无人值守运行,更不授权无边界的网站自动化。
23. 测试、监控、部署与故障处置
可靠性最终要由状态、真实调用和产物证明,不能让模型评价自己“执行正确”。测试记录应能关联构建与策略版本、task/run/step、事件水位、调用用量和产物哈希,真实集成证据与故障 fixture 分开保存。
把验收写成可观察的失败条件
聊天与阅览这一组至少验证六件事:(1)纯答复和澄清不创建研究任务;(2)无预置对象问题真实搜索、读页并产引用报告;(3)重复消息、重复 start 只产生一份有效创建;(4)消息编辑不改变旧任务绑定;(5)关闭标签页或 viewer 后任务继续,重开补齐事件;(6)无 session 不创建 context,刷新只读已有帧,切 view 不切 Owner,帧时间、stale 和 snapshot 如实展示。
执行一致性再验证五项:(7)SSE 去重、补缺、过期快照接续无漏事件;(8)claim、stop、results 竞态中停止后不发新动作;(9)旧租约及迟到产物隔离,同哈希回执不重复发事件、异哈希拒绝;(10)worker 或浏览器故障后新栅栏恢复,不重复封存已完成步骤;(11)两个任务和两个 context 确有重叠,Cookie 隔离、同域与模型限额生效。这些必须查控制面事务和受控外部请求记录,不能只看前端进度条。
安全与交付还要验证至少九项:(12)跨项目消息、帧、证据及下载均拒绝;(13)DNS 重绑定、重定向、子资源、WebSocket 和下载未命中内部网络;(14)页面注入不扩权,登录或验证码受限明确 blocked;(15)秘密不进构建、SSE、日志和截图,撤销后旧票据失效;(16)并发预留不透支,429 有限退避,unknown 费用不记零;(17)缺值、冲突、缓存时间、引用错配和公式注入按契约处理,计算可重跑;(18)存储失败不假封存,固定修订下载不偷换版本;(19)无目标数据库真实导出,选配 gateway 不给浏览器开放私网;(20)COMMIT 丢响应分别覆盖已提交、未提交和无法判定,最后一种禁止重写。Redis 关闭、备份恢复和薄壳隔离也应纳入相应阶段回归,不能只跑成功路径。
部署不是把 latest 镜像启动起来
交付应锁定 Node、Python、Playwright 引擎、系统库、字体和证书,保存依赖锁、镜像哈希、迁移版本、SBOM(软件组成清单)和许可证。先建立 TLS 加密传输、身份、MySQL 与私有文件存储,再注入秘密引用、执行批准迁移、启动 API 和 worker 探针,最后接 Web。健康检查既看进程,也看数据库可用性、出口政策和浏览器真实启动能力;选配业务库故障不应让核心应用健康检查整体失败。
迁移应在派发受控时运行,核 schema、队列状态与契约哈希兼容,不能让旧 worker 读到新字段后继续不明执行。MySQL 的部分 DDL 会隐式提交6,不能假定包在事务里就能整体回滚,也不能与业务投递 DML 混在一起。优先 expand/contract:先增加兼容结构,再切换读写,确认后收缩旧结构。应用回退必须与 schema 兼容;不可逆迁移另需批准恢复点,回退脚本不能冒充可逆保证。
监控应看队列深度与等待龄、事件落后、租约失效、迟到结果、截图 stale、引用缺口、上传失败、CPU/内存/磁盘、模型 429,以及预留与 actual 差额和未知提交年龄。事件记录具体过程,metrics 提供低基数汇总,避免把 URL 当指标标签。报告尚未产生、总工作量未知、费用待对账都用 null 或明确状态,不填零;来源拒绝、无材料、用户停止与技术失败分开计数,不制造“事实准确率”百分比。
先隔离故障,再恢复执行
viewer 掉线时,界面提示最后帧时间和“阅览断连,云任务仍在运行”。恢复只重核权限、换票据并订阅,不重建任务或刷新来源;用户真要停止需发任务命令,未收到持久 ACK 就显示未确认。MySQL 不可用时停止派发和无法核权的副作用,Redis 不能接管事实源;Redis 故障则以数据库状态恢复通知与领取,禁止从缓存猜任务已完成。
模型或搜索失联、429 激增时,暂停依赖节点、限定退避与重试预算,保留已有证据。来源授权失效或验证受限标 blocked,不用被遮罩的错误页充当有效覆盖。对象存储故障要区分上传、哈希校验、索引登记和封存阶段;无索引 staging 对象按策略回收,索引指向缺失对象则禁止交付,不能生成假的下载卡。
浏览器丢失 context 后隔离旧节点,停止旧出口动作,重新核租约、权限和预算再观察页面,不从 Cookie 检查点恢复,也不盲重放未知点击。费用异常先停有价调用,核预留、call_id 和账单。业务库提交未知保持停写,以同事务回执、全键集合和行哈希对账,不能凭 COUNT 相同判成功;旧事务未确定结束、部分存在或目标不可达都仍是未知。
备份必须联合保护 MySQL 一致视图及日志、对象版本和 manifest/hash。恢复先冻结领取,撤旧令牌与租约,隔离验证事件水位、对象引用和预算账本,再生成新栅栏小批放行;unknown 费用与 writing/未知投递先对账。RPO 十五分钟和 RTO 四小时只能作为起测目标:前者衡量可接受的数据丢失窗口,后者衡量恢复时长,实际值要由演练记录。凭据泄漏则停关联节点、撤销并轮换秘密引用、验证旧令牌拒绝;事故关闭要有根因、费用和恢复证据,未演练的手册不能被写成恢复能力。
24. 这类产品真正应该交付什么
从一份景区名单到 3,951 条整理内容,再到聊天式 AI 研究平台的方案,真正发生的变化不是多接了几个模型接口,而是交付对象发生了变化。
单次采集交付一份文件。产品还需要交付可以重复依赖的行为:用户知道任务为什么启动,系统能说明访问了什么资料,数据有来源和缺失解释,停止可以真正生效,后续执行不会改变已交付历史,费用也不会因为一句“越多越好”而失去边界。
用户体验可以很简单。进入是聊天框,提出目标以后看见计划与阶段,需要时打开右侧云端浏览器,最终获得可以使用的答案、数据和报告。这个简单界面背后,必须有持久状态、受控工具、证据关系、版本、权限和预算。
24.1 交付答案,也交付能解释答案的资料
如果用户得到一段流畅的回答,却无法知道某个数值从哪里来,那么系统还没有完成研究型产品的核心工作。
答案需要关联来源版本,关键断言需要证据,计算需要输入快照和方法。用户不一定每次都展开这些材料,但系统应当有能力在需要时解释。
当支持不足时,交付缺口比交付一个虚构的完整答案更有价值。这个原则应当体现在 Schema、质量门禁和报告结构中,而不是仅仅写在模型提示词里。
24.2 交付文件,也交付稳定版本
CSV、报告和图表是业务继续工作的入口。它们一旦下载、分享或者导入数据库,就不应被后台续采悄悄替换。
新的资料意味着新的修订,停止后的继续意味着新的任务和关联记录。历史产物可以被撤权或者按政策删除,但不能在用户不知情时改变内容。
如果平台保留多个格式,也应明确它们来自哪个数据或报告修订。多个文件不意味着多次独立研究,文件数量不能替代数据质量。
24.3 交付自动执行,也交付真实的控制能力
自动规划与多智能体并发只有在用户可以控制范围、预算和停止时,才适合长任务。
后台任务不应依赖用户一直开着页面,用户关闭阅览也不应该失去成果。但用户明确停止时,系统又必须阻止新动作和新费用调用,并把无法立即撤回的在途请求如实说明。
这种控制能力比“页面上同时显示八个 Agent 名字”更重要。真正的多智能体系统需要资源许可、独占 Owner、明确依赖和可恢复提交,而不是一段看起来繁忙的状态动画。
24.4 交付通用能力,而不是取消所有边界
一个通用研究平台可以处理不同主题,也可以通过模板形成行业数据。但通用不等于全站可访问、任意媒体可下载、任何结论都可信,或者任何外部写入都无需授权。
来源拒绝访问、资料未披露、作品用途受限、身份冲突和预算耗尽,都应当成为能够解释的正常结果。合法替代资料可以补充,不能通过绕过限制来追求表面完整。
公开资料的获取、模型处理、保存、分享和发布需要分别判断。安全和用途政策不是研究结束后的附加说明,而是每一步能否执行的条件。
24.5 下一步应该验证一条真正闭环的路径
对于这个方案,最合理的下一步不是同时实现所有格式、所有平台和所有行业,而是选定一个获准范围,打通一条完整路径:聊天提出需求,后端自动搜索和读取,形成字段或报告,保留证据,支持停止与恢复,最终产生固定版本文件。
然后再验证一个不同的研究问题,确认系统不是被景区主档和固定六表限制。接着加入真实并发、断网、失租、预算和部分失败场景,检验它是否仍然保持一致。
这篇文章记录的是从已完成采集实践推导出的产品与工程设计。云搜浏览器的服务、阅览通道和多智能体集群还需要实际开发与验收。图稿和协议帮助把目标讲清楚,但它们不能代替已经运行的系统。
最终,这类产品应当让用户用简单的话提出问题,同时让后端以可核验、可控制、可持续交付的方式完成工作。
References
以下公开文档用于支持浏览器隔离、结构化输出、工具调用、数据库与安全机制的技术说明。本文的产品布局、服务拆分、模式命名和实施流程是本项目设计,并非这些文档对平台已实现能力的认证。